
颱風過境那天清晨,手機螢幕跳出的第一則通知往往決定了一整天的行動走向。即便官方氣象站隨後發布了詳盡的風力等級、累積雨量、各區交通與學校安排,大腦中最先成型且最頑固的判斷,多半直接來自排版最顯眼、標題字體最大的那句話。這種由資訊呈現形式主導評估的現象無處不在,深刻影響著個人決策與企業資源分配。
日常進行風險評估時,決策者鮮少進行精確的概率運算,往往直接讀取眼前材料的呈現形狀——哪些內容被置頂、哪些維度被放大標註、哪些關鍵數據被縮小移至角落。這種「以呈現特徵代替真實屬性」的現象,正是造成輸入啟發式關聯風險的核心成因。當資訊優先表示機制介入時,大腦容易產生兩類偏差:將毫無關聯的事件串連成因果,或將共享底層風險的關鍵項目拆解成孤立事件。
先界定術語:認知捷徑與呈現機制的交界
在判斷與決策領域中,Tversky 與 Kahneman 於 1974 年在《Science》發表的研究(詳見 PubMed 收錄的〈Judgment under Uncertainty: Heuristics and Biases〉)奠定了經典框架,將不確定性下的判斷歸納為代表性、可得性以及錨定與調整三種啟發式路徑。
經典的可得性啟發式著重於「容易從記憶中提取的事物常被判定為高頻發生」,側重記憶層面的檢索阻力;而此處討論的焦點在於「被版面推到眼前的事物被判定為關鍵風險」,著重於當下材料的注意力配置機制。兩者雖常交互影響,但干預手段截然不同——前者牽涉長期記憶與認知經驗,後者則由排序、視覺顯著度、計量單位與資料分組等即時呈現決定直接導引。
這與 Kahneman 及 Frederick 在〈A model of heuristic judgment〉(見 UCLA 論文庫收錄版本)中提出的屬性替代高度呼應:當評估「真實危險程度」過於複雜時,決策者會不自覺地用「視覺材料看起來有多緊迫」來作答,落入所見即全部(WYSIATI)的盲區。因此,檢視這類風險並非創造新心理學流派,而是建立一套檢視工具,用以盤點材料製作過程中各項呈現手段如何替受眾過早決定了優先級。
關聯風險的兩層結構
在資訊傳遞過程中,呈現形式常在以下兩個層面扭曲對相關性的判斷:
- 虛假因果鏈的建立:兩個在現實中各自獨立的事件,僅因在版面上相鄰呈現(例如並排的新聞版面、同一張圖表或同頁清單),大腦便會自動腦補邏輯連接,誤將並存視為互為因果。
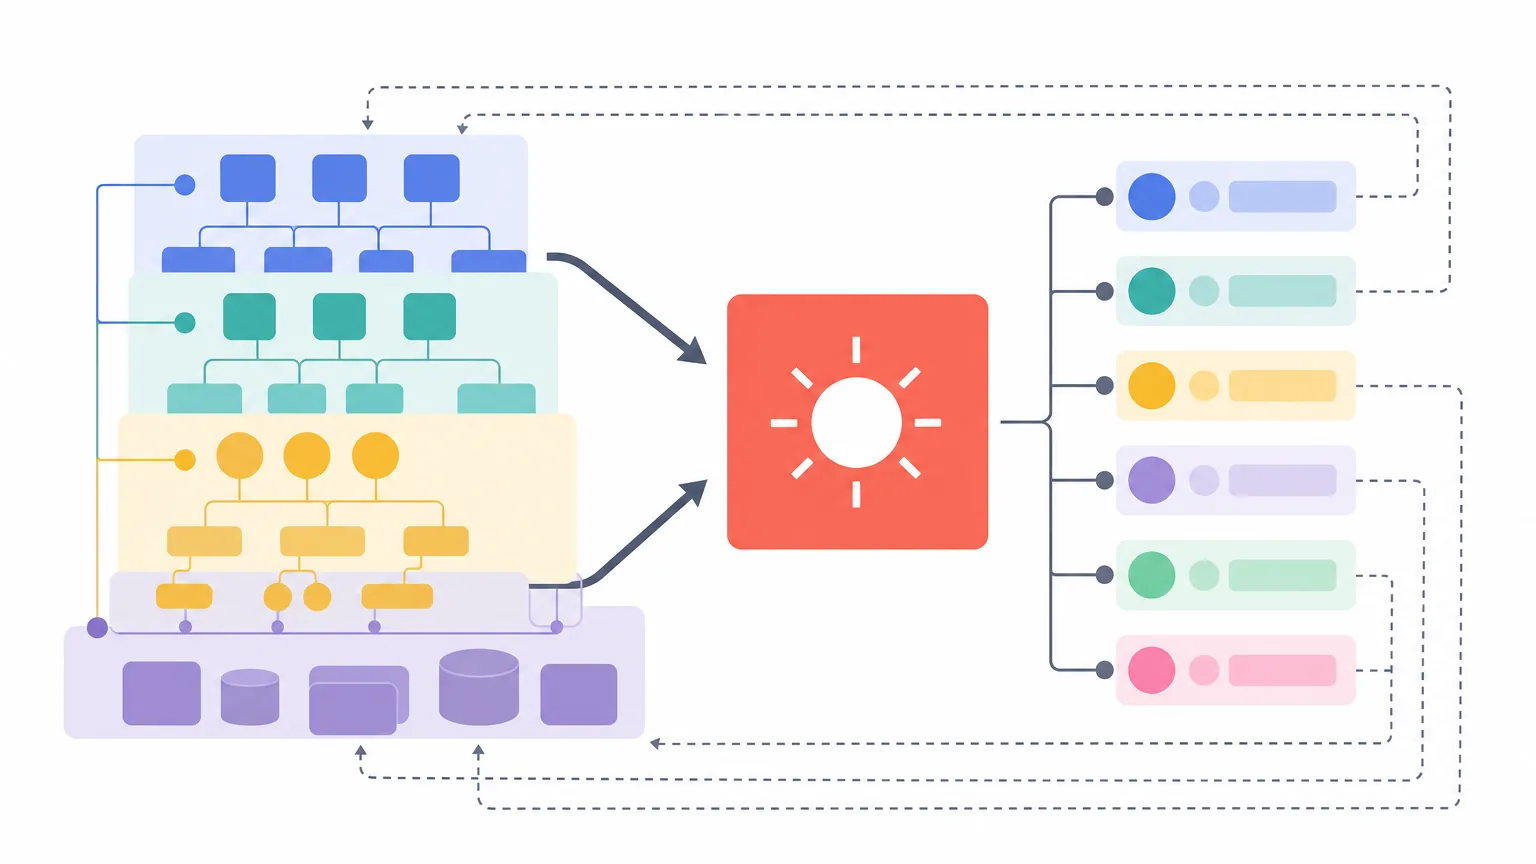
- 共源結構的隱蔽:多個風險項目實際上來自同一個脆弱環節(例如共用單一雲端節點、特定原料供應商或同一法規變更),但因被拆分填入不同業務模組的表格,在視覺上呈現為彼此獨立的輕微風險,導致組織喪失系統性防護視角。
排序效應:版面位置主導資源傾斜
在各類管理報表或投資決策介面中,排列順序往往直接轉化為重要性評判。例如投資平台的基金篩選列表若預設按「近一年報酬率」由高至低排列,前幾名自然獲得極高點擊與資金湧入,其伴隨的波動率、流動性指標與費用結構則因被收納於內頁而被淡化。
當排序鎖定注意力的前端,排在前面的議題便順理成章佔據了絕大部分審閱精力與預算份額,這種注意力分配的不均等進一步強化了「排在前面必然更重要」的認知反饋,最終讓形式上的序列完全凌駕於實質風險權重之上。
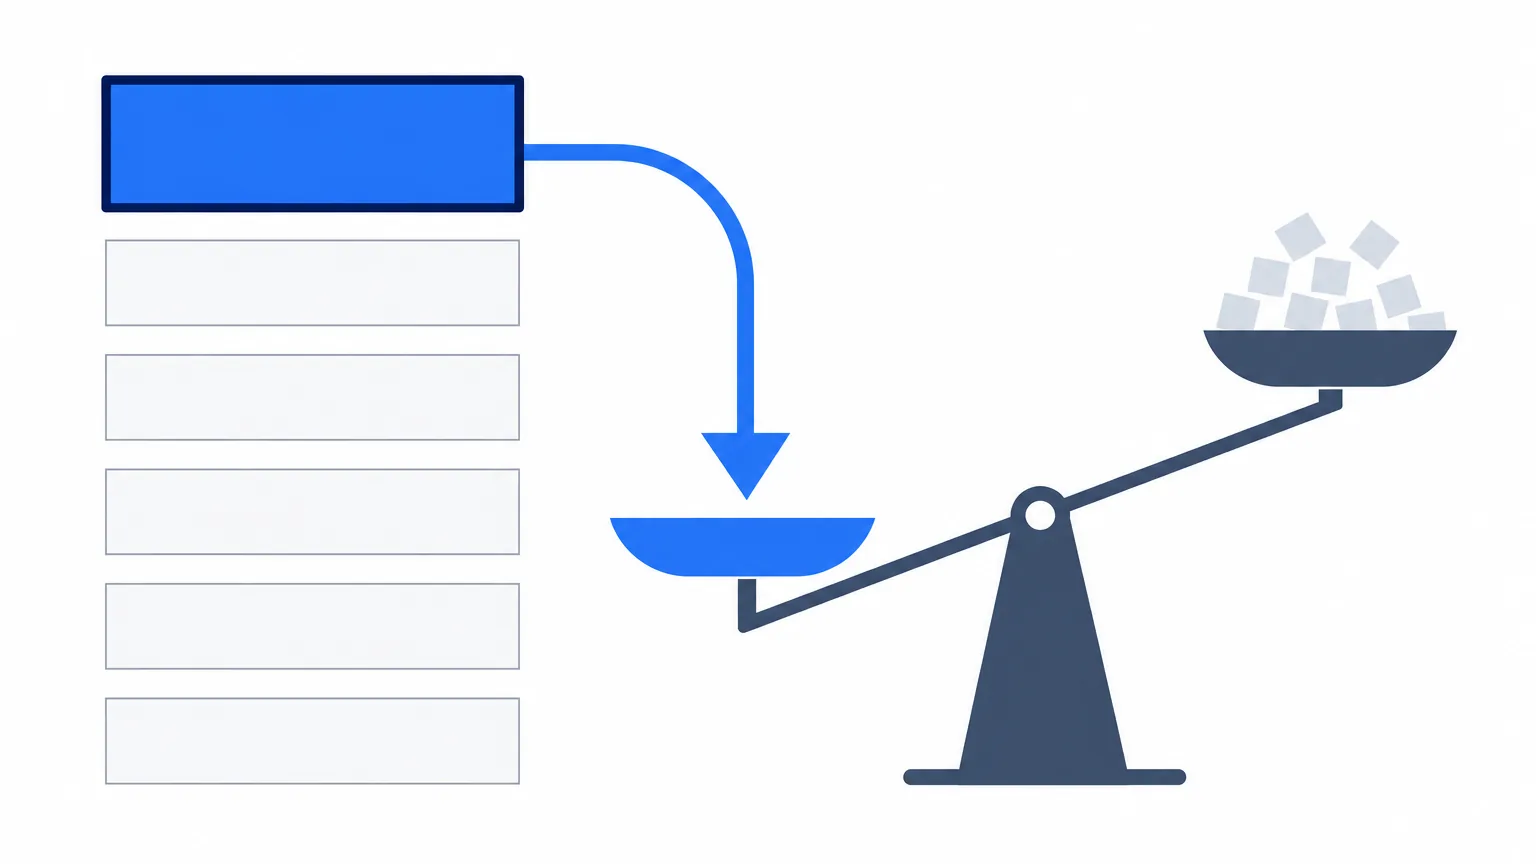
任何項目只要在版面中取得首位,便預先鎖定了注意力分配與後續資源。排序帶來的偏差不僅是心理感受,更直接體現於預算與人員配置的實際流向。
視覺顯著度與離散化工具的失真陷阱
除了順序,字體大小、警示色彩與版面標籤的強度往往比純粹的數值更具衝擊力。資安監控平台的警報系統若僅依循時間倒序置頂,容易使分析人員陷入處理即時瑣碎事件的疲態,導致真正具有潛在威脅但頻率極低的深層異常被淹沒。
傳統風險矩陣的色彩離散化處理同樣存在類似問題。Tony Cox 在《Risk Analysis》發表的經典論文(詳見 RePEc 收錄的〈What’s Wrong with Risk Matrices?〉)中明確指出,風險矩陣受限於分類解析度,容易產生「風險反轉」或將實質損失差距極大的項目歸入同一個黃色或紅色等級區間。過度依賴視覺填色,常使決策者忽略同一色塊內部龐大的概率與損失區間分佈。
單位、基準與分母:資訊呈現手法的盲點對照
數值若脫離了參照基準與分母,其代表的嚴重程度便極易被隨意扭曲。以下整理常見呈現手段及其引發的解讀盲點:
| 常見呈現手法 | 容易導向的直覺結論 | 實質被隱藏的關鍵維度 |
|---|---|---|
| 僅標註絕對數值(如新增百起案例) | 情況劇烈惡化,需全面警戒 | 總體母數大小、統計覆蓋率與週期長度 |
| 僅展示增長百分比(如激增200%) | 風險增速失控 | 原始基數極低時產生的百分比倍增假象 |
| 圖表座標軸未從原點(零)起算 | 走勢波動劇烈、趨勢斷崖式下滑 | 實際波動幅度僅在微小區間內正常擺動 |
| 同圖並列不同口徑之曲線 | 兩項指標強烈聯動、具因果關係 | 統計母體與採樣頻率不匹配的巧合走勢 |
| 精簡版摘要僅保留 Top 3 重點 | 整體威脅已全數受控於三個要點內 | 被過濾掉的長尾威脅與潛在系統性風險 |
錨定數值與敘事框架的心理拉力
當評估清單給出第一個基準數字時,該數值便成為整場判斷的支點。無論是採購評估中的首行報價,或是報告首頁所標記的歷史損失數據,後續的所有評估多半僅圍繞該數值進行微調,鮮少推翻重來。
此外,具體生動的故事往往比抽象統計更能刺激行動。一段充滿細節的損失個案敘述,常被賦予過高的出現機率估計;反觀冷靜的基率統計則容易被邊緣化。當生動敘事成為唯一的輸入源時,決策基礎便容易從實質概率退化為情緒反應。
智慧儀表板與自動摘要帶來的新挑戰
現代管理高度依賴視覺化儀表板與各類智慧摘要工具。首頁固定的指標卡片在提供便利的同時,也宣示了其他指標的邊緣化;長期未更新的監控維度會使組織對新型態風險視而不見。
自動摘要工具在精簡長篇報告時,往往根據模型權重產出簡要結論,略去了原始脈絡中充滿不確定性的邊界條件與警告備註。這類摘要文字往往讀起來比原文更具確定性,使查閱者容易將「概括內容」誤認為「事實定論」。為抵消此效應,摘要工具產出的每項重點皆應具備回溯至原始章節的鏈接標記,並在決策流程中保留未納入摘要的項目盤點。
建立抗偏差的標準化核對機制
要有效降低資訊呈現對判斷的干擾,需落實具體可執行的工作流程:
- 基準前置化:在檢視各項案例前,先行確立概率區間與影響力度的評估定義,並附上標準參考值,防止標準隨個案浮動。
- 獨立初審與盲評:在進行跨部門綜整前,由各評審人員獨立記錄評估數值與依據,削弱首位發言或首頁數值形成的錨定引力。
- 呈現順序常態輪替:定期調整會議報告、清單檢視的預設順序,避免固定領域長期壟斷黃金審閱時段。
- 雙軌指標對照:展示絕對數值時強制配搭母體分母;呈現百分比時同步標註原始基準,圖表一律提供基準軸線校驗。
- 區隔「未知」與「無風險」:在數據矩陣與儀表板中嚴格區分「未監測(無數據)」與「已評估且無顯著威脅」,防止空白欄位被直覺解讀為安全。
- 增設共源檢查欄:於評估清單中加入強制欄位,專門記錄該項目與其他業務模組是否共享供應鏈、軟體底層或法規環境。
- 歸檔輸入狀態快照:重大決策拍板時,連同當時所依據的儀表板版本、排序規則與摘要原稿一併封存,以利事後客觀覆盤。
決策當下的快速自檢清單
面對重大方案評估,可藉由以下問題打破既有的資訊呈現框架:
- 若將目前置頂的項目移至最尾端,整體資源配置的方向是否會改變?
- 目前的判斷是基於實質數據,還是受到標題字體與警示顏色的推動?
- 引用的統計比率,其對應的計算分母與採樣週期究竟為何?
- 兩個同時出現的異常,是純屬時間巧合,還是具備同源機制?
- 這份精簡摘要忽略了哪些長尾細節,排除的理由是什麼?
- 目前表格的預設排序規則由誰制定,上次重新審視規則是何時?
常見問題 FAQ
Q1:輸入啟發式與一般認知偏差最大的差異在哪裡?
傳統認知偏差多著重於個體大腦的思維盲區與長期記憶提取限制;此處探討的輸入偏差,核心在於外部材料的排版順序、視覺層級與資料封裝方式如何主動引導並塑造了注意力分配,問題關鍵在於呈現結構本身。
Q2:既然風險矩陣可能導致解析度不足與反轉,是否應全面停用?
風險矩陣具備良好的溝通直觀性,不需完全揚棄,但不能作為唯一決策依據。實務上應在各色塊內註記未經離散化的原始估計區間與置信水平,避免將同一格內的異質風險視為完全等同。
Q3:如何在不增加龐大工作量的前提下排查「同源風險」?
最簡便的作法是在現有表格中增列「外部依賴項目(如共用供應商、底層系統、關鍵法規)」。只要要求填表人勾選相應關聯,系統便能自動交叉比對,找出分散在不同部門但本質共源的潛在連鎖隱患。



