
當亞太區多個AI數據中心的算力出現階段性波動,外界的討論往往集中在模型訓練任務排隊、在線推理成本攀升或是產品迭代延期。對基礎設施與網絡架構團隊而言,更直接的衝擊在於底層流量圖譜的劇烈位移:骨幹網上的延遲曲線與頻寬分佈正在悄然重排。過去按傳統模型預估的鏈路容量,可能在離峰時段突發擁塞;原先整夜維持高吞吐的波分通道,轉為深谷與陡峭尖峰交替。探討算力下降對網絡影響,不能只看計算節點本身,而必須穿透多層傳導機制,看清從GPU機架到跨區骨幹網的連鎖效應。
算力側的狀態變更通常來自兩類截然不同的驅動因素:一類是物理資源與供應收縮(如GPU晶片交付延後、數據中心電力配額收緊、散熱系統改造停機或機房搬遷);另一類則是調度策略與架構調整(如任務排程切換、並行模式變更或推理架構解耦)。這兩類成因對網絡鏈路的影響方向大相徑庭:前者多引發跨境繞行與重試風暴,後者則徹底改寫流量的時間節奏與突發特徵。混淆兩者的本質,會直接導致網絡容量規劃失準。
流量節奏重塑:脈衝化與時間結構位移
分佈式訓練集群的網絡負載具有嚴格的時間結構。以資料並行(Data Parallelism)為例,每個訓練步驟(step)結束時均需執行集合通信(如 All-Reduce)以同步梯度。這段通信在前向與反向傳播計算之間形成高度規律的階梯狀流量脈衝,其頻率與峰值取決於集群規模、批次大小(batch size)與網絡拓撲。當可用計算節點收縮時,計算耗時佔比拉長,集合通信的觸發間隔隨之延後,機架間的空窗期變長。此時骨幹網呈現的不再是平穩的高吞吐曲線,而是一串間隔更長但瞬時更陡峭的流量脈衝。
在此情境下,單條鏈路的實際負載取決於網絡拓撲與通訊排程。雖然參與節點減少通常會使整體總通訊量下降,但瞬時迸發的流量若集中在少數上行鏈路(Uplink),依然會引發劇烈的端口擁塞。網絡運維若僅依賴「平均頻寬利用率」評估容量餘裕,極易在陡峭脈衝抵達交換機時直接撞上隊列上限,造成嚴重的微突發(Micro-burst)。
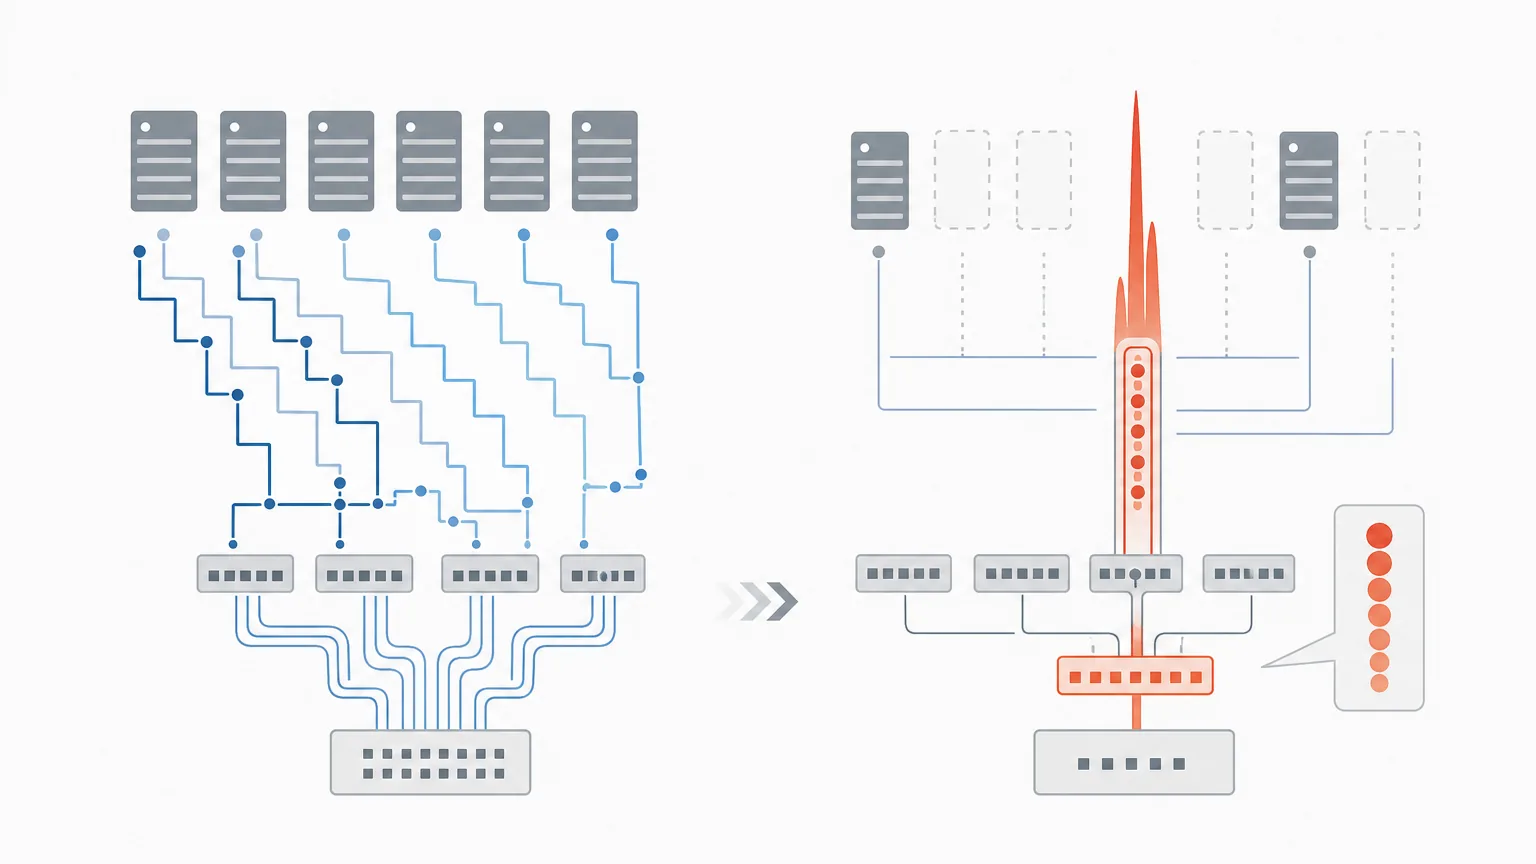
任務分時排隊機制進一步重構了流量地圖。算力受限時,調度器常將大型任務延後至夜間或週末運行,使高吞吐脈衝轉向傳統的非繁忙時段。這些時段恰好是電訊營運商進行光纖割接、設備升級與系統備份的黃金維護窗口。AI流量脈衝與維護窗口重疊,會顯著拉高鏈路抖動與丟包風險;若任務被迫擠入日間時段,又會與企業辦公及跨境專線流量激烈爭搶,導致骨幹網的動態冗餘度驟降。
從GPU機架到骨幹網:延遲逐層放大的三條路徑
1. 東西向無損網絡敏感度與隊頭阻塞
分佈式計算的集合通信對延遲抖動具備極高的敏感性。在同步歸約機制下,單一節點或鏈路的短暫延遲會直接拖慢整個集群的迭代效率。為此,AI Fabric 普遍依賴顯式擁塞通知(ECN)與優先級流量控制(PFC)來構建無損網絡環境。
然而,這類機制的運行效能高度依賴穩定的流量模型。緩衝區(Buffer)閾值與標記參數通常是針對特定的並發連接數與到達率精細調校的。當算力資源受限導致分佈式架構從資料並行切換為流水線並行(Pipeline Parallelism)或專家並行(MoE)時,流量模式會轉變為短突發、高並發特徵。若無損網絡參數未同步校準,PFC 暫停幀可能被頻繁觸發,進而誘發隊頭阻塞(Head-of-Line Blocking, HoL Blocking)。網絡監控面板上可能顯示鏈路利用率不高且無丢包,但訓練任務的吞吐量卻顯著崩塌。
2. 推理架構解耦與跨區繞行
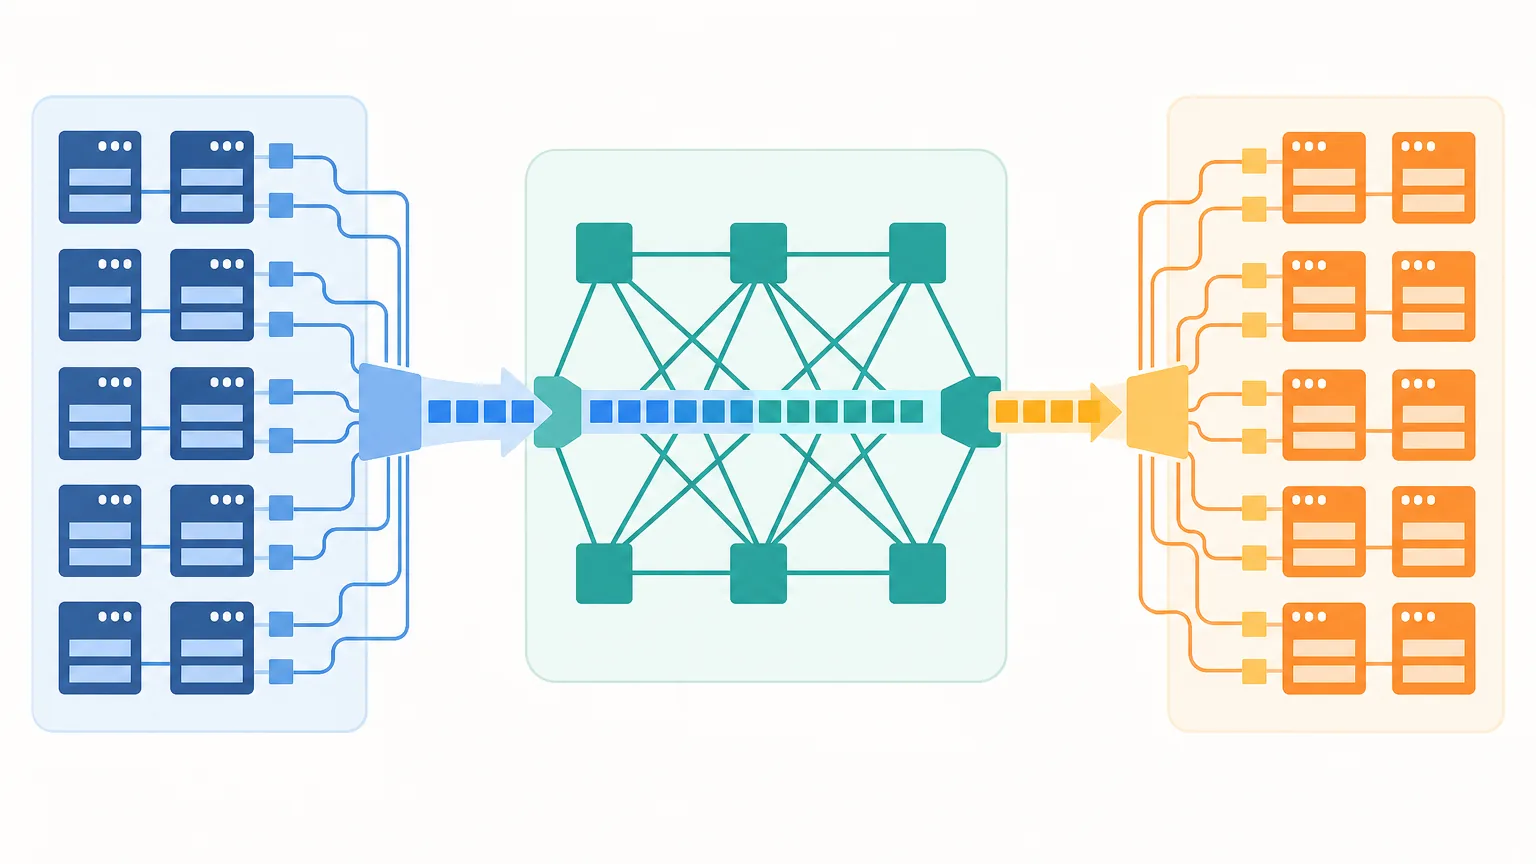
在推理端,本地算力不足最直接的代價是跨區請求轉發。邊緣節點接收到的請求需經由城域網、骨幹網乃至海底電纜繞行至遠端機房,來回往返(RTT)將直接墊高延遲底線。
現代大模型普遍採用的 Prefill 與 Decode 分離(Disaggregated Inference)架構加劇了這一網絡負擔。SambaNova 廠商技術說明指出,計算密集的 Prefill 階段與受限於記憶體頻寬的 Decode 階段拆分部署,能提升算力利用率,但代價是大量 KV Cache(鍵值快取)必須在不同集群或 Pod 之間實時傳輸。當算力配比失衡時,調度器被迫跨站點傳輸上下文張量,使跨集群鏈路的頻寬負擔與傳輸延遲同步攀升。此外,IETF BMWG 相關工作組個人草案(draft-calabria-bmwg-ai-fabric-inference-bench-00)在探討推理基準時亦提及,當 Prefill 與 Decode 節點分處不同單元時,快取流量將穿越核心交換網絡(Superspine 層),直接使核心層頻寬成為限制端到端響應的關鍵瓶頸。
3. 應用層重試引發的正反饋風暴
客戶端與網關通常配置有固定的超時閾值(如首字延遲 TTFT 上限)。當算力排隊推高 P99 延遲時,超時未響應的請求會被客戶端中斷並觸發自動重試。這類無效的重試請求不僅重複佔用傳輸頻寬,更會重新進入算力隊列爭搶計算資源。頻寬被無效重試佔據引發更嚴重的隊列積壓,進而觸發更大規模的超時重試,在骨幹網絡上形成正反饋惡性循環。
架構實踐準則:算力側排隊延遲每上升一個數量級,網絡與網關側就必須同步檢視超時預算與退避機制(Backoff)。算力調度若與網絡層策略脫節,延遲劣化將以倍數級擴散。
骨幹網絡頻寬曲線的「形狀異變」
傳統骨幹網的容量規劃高度依賴歷史流量矩陣(Traffic Matrix)。算力供應的波動並不會單純使總流量等比例收縮,而是直接改變流特徵(Flow Characteristics):
- 長流轉短流的處理開銷:以「大象流(Elephant Flows)」為主的模型訓練流量具備長連接、大封包特徵;而在線推理與 API 調用則由數以億計的「老鼠流(Mice Flows)」構成。當訓練佔比下降、分佈式推理請求增加時,即使總位元吞吐量(Gbps)未達上限,路由器與交換機的每秒新建連接數(CPS)、封包轉發率(PPS)以及流表記憶體負擔均會大幅增加。
- 流量工程(Traffic Engineering)失配:基於分段路由(Segment Routing)或 MPLS-TE 的頻寬預留通常根據固定歷史週期計算。AI 業務調度的快速變化會導致預留路徑出現資源空置,而實際爆發的繞行流量卻在無保護的路徑上引發擁塞,造成「整體頻寬富餘而局部嚴重丟包」的失衡現象。
物理層聯動:電力約束與硬件調節
算力下降的物理起因常伴隨網絡基礎設施的連鎖反應。當數據中心面臨電力配額上限時,運維策略可能主動對非計算設備進行能耗調節,例如關閉部分交換矩陣、降低非關鍵端口協商速率或停用冗餘光模組。
端口降速運行直接削減了等價多路徑路由(ECMP)的可用鏈路數,大幅削弱網絡的負載均衡能力與容錯餘裕。若流量工程系統未及時同步鏈路權重,流量仍會湧入降速端口引發擁塞。此外,機房散熱升級或硬件維護引發的節點頻繁離線,會導致 BGP 等路由協議反覆收斂,產生大量控制面開銷與短暫的微環路(Micro-loops)。
跨層觀測體系:指標映射與排障信號
要準確定位網絡異常的算力根源,必須建立跨越計算與網絡邊界的觀測矩陣:
| 算力側變更事件 | 網絡側可觀測信號 | 常見誤讀與排障陷阱 |
|---|---|---|
| 訓練集群規模收縮 | 集合通信間隔拉長,單鏈路瞬時突發峰值陡增 | 誤以為平均負載降低即可縮減網絡冗餘 |
| 推理請求跨區調度 | 跨區 RTT 顯著抬升,跨境海纜鏈路流量激增 | 誤判為骨幹網頻寬不足而盲目擴容波分通道 |
| 排隊超時引發連鎖重試 | 並發連接數陡增,短連接小封包佔比異常飆升 | 誤認為遭遇外部 DDoS 攻擊或惡意掃描 |
| 能耗調控下的設備降速 | 端口協商速率下降,ECMP 條帶化分佈不均 | 誤判為光模組老化或光纖物理故障 |
| 並行架構與策略調整 | PFC 暫停幀頻繁產生,ECN 標記激增但無丟包 | 誤認為核心交換機背板轉發能力不足 |
香港與區域樞紐的網絡處境
香港作為亞太區關鍵的國際網絡樞紐,在算力與流量重組中承擔著雙重角色。根據 SubmarineNetworks 登陸站資料整理,香港擁有多個海底電纜登陸站(主要分佈於將軍澳、舂坎角及塘福等區域),是亞太數據過境的核心節點。然而,新增網絡基礎設施的部署需要經歷嚴格的審批與建設週期,正如 香港通訊事務管理局辦公室(OFCA)關於海底電纜登陸的指引 所述,相關登陸與鋪設涉及法定牌照及土地協調程序,海纜容量擴充本質上屬於中長期規劃。另據 Submarine Cables Summit 關於高容量新海纜系統的行業報道 分析,區域數據中心的電力配置與空間擴容節奏,長期對整體算力基建形成客觀約束。
當周邊區域的算力供給出現缺口時,香港既作為推理請求的承接方,也扮演著跨區轉發的中繼樞紐:
- 延遲敏感型流量承接:金融交易、實時語音與互動式 AI 應用對 RTT 具備極低容忍度。周邊算力不足導致請求向香港匯聚時,若無精細化的服務質量(QoS)分級,大流量傳輸將直接擠壓核心交互業務的延遲預算。
- 企業專線與 AI 突發流量爭用:許多跨境企業專線原先僅承載標準業務數據。當本地部署的大模型 API 轉向遠端備用集群調用時,專線鏈路會突發超出合約基準的流量,導致關鍵業務數據面臨降級或排隊抖動。
網絡優化與架構落地方案
- 容量評估轉向 P99 與微突發監控:棄用以「平均利用率」為核心的擴容標準,全面改以 P99 隊列長度、突發持續時間與緩衝區佔用率作為網絡擴容依據。
- 網絡參數與計算拓撲聯動審查:每次變更大模型訓練並行模式或批次大小時,自動化同步複核交換機 ECN 水位、PFC 門限與緩衝區分配策略。
- 部署具備延遲感知(Latency-Aware)的智能路由:網關與負載均衡器在分發推理請求時,應將「跨區網絡 RTT」與「目標節點隊列排隊耗時」綜合加權計算,避免將流量導向網絡延遲過高的遠端節點。
- 實施自適應退避與重試熔斷:為所有 AI API 接口配置全域重試預算(Retry Budget)與指數退避(Exponential Backoff),在算力隊列積壓時主動熔斷無效重試。
- 存儲流量與前端推理物理/邏輯隔離:模型權重分發、檢查點(Checkpoint)寫入等巨型流量必須配置專屬隊列或獨立通道,杜絕與交互式在線流量混跑。
- 推動輕量模型邊緣化下沉:對延遲極度敏感但算力需求有限的任務(如數據前處理、意圖識別),直接下沉至邊緣計算節點處理,大幅節省骨幹網頻寬與往返耗時。
常見認知誤區
- 誤區一:算力下降必然帶來網絡負擔減輕。雖然總傳輸位元可能降低,但轉發繞行、隊頭阻塞與重試流量往往大幅上升,網絡實際體驗指標(P99 延遲與抖動)反而顯著惡化。
- 誤區二:只要頻寬充足就不會產生性能瓶頸。頻寬僅代表管道寬度,延遲與抖動取決於傳輸物理路徑、隊列深度與交換機封包轉發能力。在跨區繞行場景中,單純加大頻寬無法克服光纖物理傳播延遲。
- 誤區三:單純依賴網絡擴容可解決一切擁塞。若核心瓶頸在於應用層無節制的超時重試或無損網絡參數失配,增加頻寬只會使突發流量更快速地壓垮下游網絡設備。
未來演進趨勢
展望未來的架構演進,算力調度與網絡工程的深度融合是必然趨勢。傳統架構中計算調度器與網絡路由彼此獨立運行的壁壘正在被打破,新一代算網協同調度系統將實時鏈路延遲、海纜負載與可用頻寬作為一級權重納入計算排程。
與此同時,全光交換技術(Optical Circuit Switching, OCS)與可重構光網絡的探索,為動態流量提供了更高的適應能力。在算力資源動態波动的環境中,光層拓撲的動態重構能有效平衡節奏異變帶來的負載衝擊。理解底層網絡與算力狀態的共生關係,建立全鏈路的動態協同機制,才是保障高可用基礎設施的關鍵所在。
常見問題(FAQ)
Q1:為什麼算力集群規模縮小後,網絡的瞬時突發反而可能更嚴重?
當計算節點減少時,任務的計算時間變長,使得集合通信(如 All-Reduce)的觸發頻率降低、間隔拉長。然而,若單一節點需要同步的張量數據量未顯著減少,且網絡拓撲集中於少數上行鏈路時,流量會高度濃縮在短時間內迸發,形成「平均負載低、峰值極其陡峭」的微突發,極易引發交換機緩衝區溢出。
Q2:如何區分在線推理延遲增加是由網絡擁塞還是由算力不足引起的?
可通過拆解首字延遲(TTFT)與網絡往返時間(RTT)進行定位。若客戶端到網關的 RTT 保持平穩,但請求在網關處的排隊耗時與 GPU 處理耗時增加,根源在於算力不足;若跨區 RTT 本身大幅攀升、伴隨 TCP 重傳率上升與連接建立時間延長,則主要源於跨區繞行帶來的網絡傳輸與隊列延遲。
Q3:無損網絡(Lossless Network)出現性能下降但監控未見丟包,可能的原因是什麼?
這通常是由優先級流量控制(PFC)引發的隊頭阻塞(HoL Blocking)。當流量模型改變但 ECN/PFC 水位未重新適配時,交換機為防止丟包會頻繁向上游發送暫停幀,導致整條數據鏈路傳輸速率急劇下降。此時雖然沒有物理丟包,但有效吞吐量已發生實質性崩潰。
Q4:在跨區推理調度中,如何有效避免重試風暴拖垮骨幹網?
應在 API 網關與客戶端實施三層防護:首先是設置合理的超時閾值,避免過早判定失敗;其次是強制啟用指數退避與隨機抖動重試機制(Jittered Backoff);最後是在網關側配置全域重試預算熔斷機制,當系統檢測到整體失敗率達到閾值時,主動拒絕額外重試請求,阻斷正反饋鏈條。



