
手上有一份數十萬行的客戶資料,裏面混雜著住宅、商廈、街鋪與村屋,每一行都是一串文字,例如「沙田石門安群街3號京瑞廣場1期12樓A室」。這種字串可以檢索、可以排序,拿去做真實距離運算卻完全不可行。地址聚類分析原理所處理的正是這個斷層:先把字串轉換成可量測的幾何坐標,再按空間鄰近程度、實體密度與業務物理邊界,劃分出精準的地理分群。
整條工程鏈路上有幾個核心節點會直接顛覆分群成果:地理編碼精度、空間距離定義、算法模型選擇與半徑參數。任何一環隨手套用預設值,產出的群組哪怕在地圖上看似整齊,交付給營運團隊往往無法落地——車輛跨越收費隧道、同一個大廈群被硬生生拆散、偏遠離島被併入市區站點。摸清每一步的運作邏輯,是確保空間分群能落地的關鍵。
文字地址轉化為空間坐標的運算前置
地址的寫法服務於人類閱讀,演算法依賴的卻是數值。同一個門牌可以寫成「旺角彌敦道750號」、「750 Nathan Road, Mongkok」,或是「九龍旺角彌敦道七五零號」。三組字串的編輯距離很大,指向的物理空間卻完全一致。若直接對文字進行特徵聚類,會被判定為三個不同實體,分群結果反映的只是書寫習慣,而非地理分佈。
地址標準化因此是第一道工序:把字串拆解為地區、街道、門牌號、大廈名稱、座數、樓層與單位等結構化欄位。以本地空間特徵為例,大型屋苑或指標建築的名稱往往比門牌號碼更具定位價值,例如「美孚新邨」橫跨多條街道與多期工程,單獨抽取建築複合體標籤,能大幅降低後續的空間誤判。
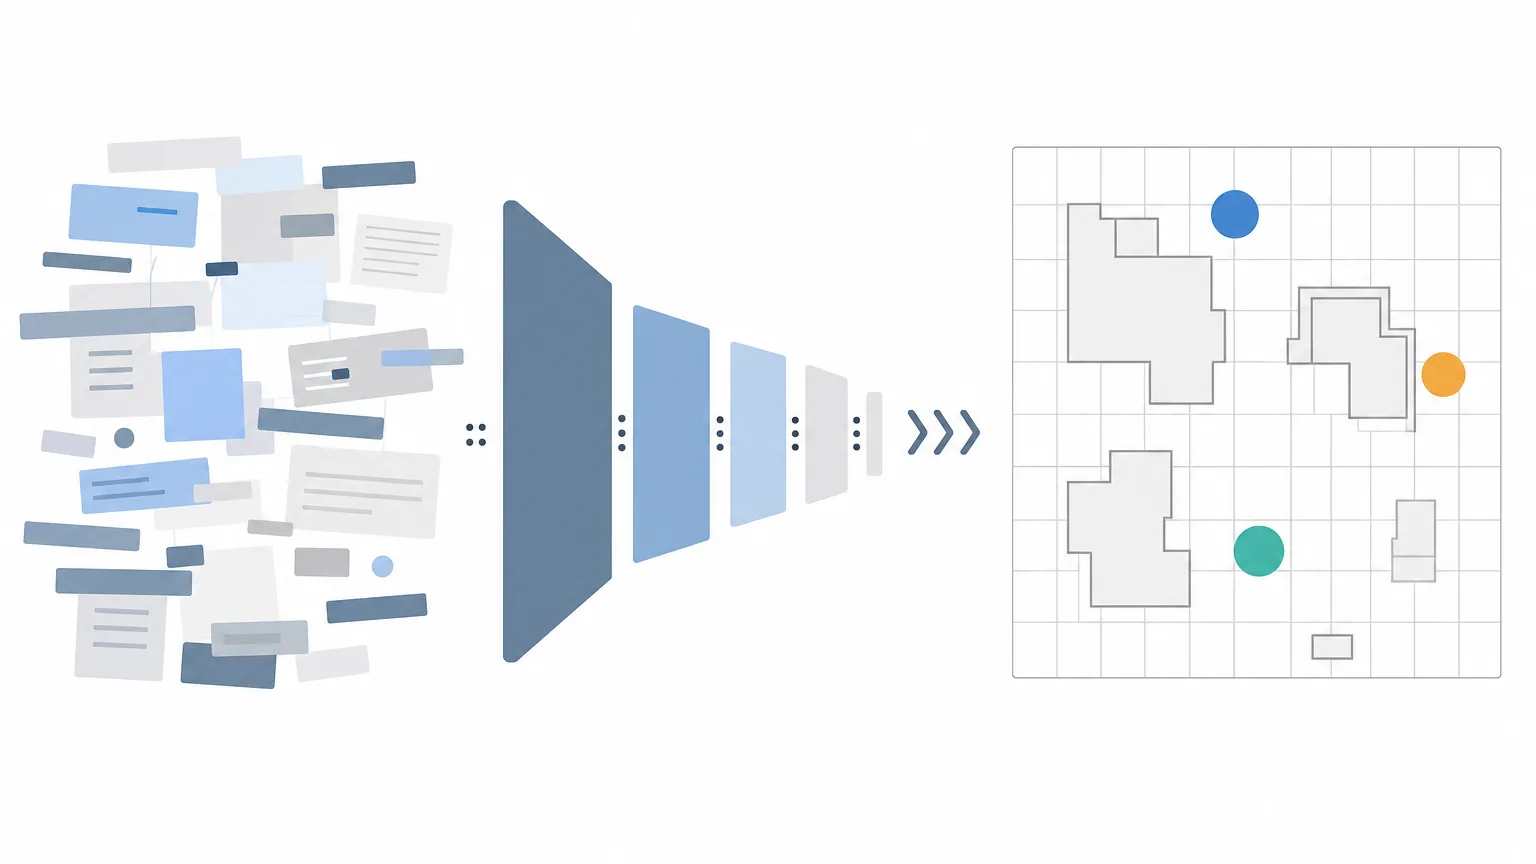
資料源選型上,官方資料如香港地政總署開放數據(如土地界址與地理標籤資料)、政府地理資訊地圖資料庫,以及商業 Geocoding API(如 Google Maps、Mapbox)各有取捨。標準化輸出必須保留匹配精度標籤:門牌級、大廈級、街道級或行政區級。門牌級的誤差多在數十米內,地區級可能偏離數公里。保留該標籤,能在聚類時將粗略點單獨隔離或降權,避免極端偏差值扭曲群組幾何中心。
地理編碼與空間坐標系校正
主流地理編碼接口預設回傳 WGS84(EPSG:4326)經緯度系統,而本地工程規劃與測繪圖則多採用香港 1980 方格網坐標(HK1980 Grid,EPSG:2326),以米為單位。兩套坐標若混雜在同一資料表內,距離運算會徹底崩潰。在資料匯入階段統一投影系統是硬性前提。
經緯度屬於球面坐標,直接套用平面歐氏距離公式會產生結構性形變。赤道處經度 1 度的地面距離約 111 公里,而在北緯 22.3 度左右的區域,經度 1 度的物理長度約為赤道長度乘以餘弦值(約 0.925)。這意味著經度方向的物理距離比緯度方向短了約 7.5%。若未加修正直接拿經緯度計算歐氏距離,所產生的群組會在東西方向被拉長,呈現不自然的扁平形變。
解決路徑有兩種:針對百萬級大規模資料,可將坐標投影至 HK1980 平面坐標(單位為米),直接套用二維歐式距離加速矩陣運算;若採用通用 Web Mercator 投影,在同一緯度帶內尺度因子大致均勻,亦可取得良好近似。小規模運算則可採用 Haversine 大圓距離公式進行球面計算,維持幾何真實性。
距離定義決定分群邊界的形狀
聚類模型本身無法理解地形,輸入甚麼距離維度,模型便輸出對應的空間形態:
- 球面大圓距離:以球面公式計算兩點直線距離,適合跨區域宏觀統計,運算穩定但無法反映地表阻隔。
- 平面歐氏距離:投影後的二維直線距離,運算效率極高,支援 kd-tree 或 Ball Tree 索引結構進行大規模空間搜尋。
- 曼哈頓距離:適用於棋盤狀街區網絡,計算沿網格折線的長度。
- 路網距離與行車時間:透過路網拓撲圖計算實際抵達成本,能精準反映隧道、單行道與跨海橋樑的阻隔,但 API 成本與運算開銷最高。
- 空間與語義混合距離:融合地理直線距離、大廈文字相似度與行政區隸屬度,用於地址去重與建築群合併。
將軍澳與柴灣直線距離僅約數公里,若僅以直線距離聚類,演算法極易將其歸入同一個群組。在實際配送場景中,跨越維港或收費隧道會增加高昂的時間與路費成本。實務架構通常採取兩階段聚類策略:先以空間投影距離進行網格或快速粗篩,再將群邊界的邊緣點導入路網距離矩陣進行二次修正,平衡系統運算負載與真實路況精度。
四大類聚類演算法在地址分群中的取捨
空間聚類算法的底層邏輯各有側重,選型失誤比超參數調優偏差更難在後續流程中彌補。
劃分式:K-Means 與 K-Medoids
K-Means 透過迭代更新幾何中心點,收斂速度極快,配合 MiniBatch 抽樣能輕易處理百萬行地址記錄。但其產出的群組多為均勻球形,且群中心為算術平均值,在複雜地形中極易落在海灣、山脈等無實體地址的空白區域。
K-Medoids 則嚴格挑選資料庫中真實存在的點作為中心點,抗離群點干擾能力強,在自提櫃、物流前置倉的候選位址挑選上更具業務價值,缺點是距離矩陣計算的時間複雜度較高。
密度式:DBSCAN、HDBSCAN 與 OPTICS
DBSCAN 依賴掃描半徑(eps)與核心點閾值(minPts)運算,可自動探測沿著道路、海岸線自然延伸的任意不規則形狀群體,並將偏遠孤立點標記為雜訊(Noise)。這一特性在地址清洗中極為實用,能自然隔離輸入錯誤的落點。
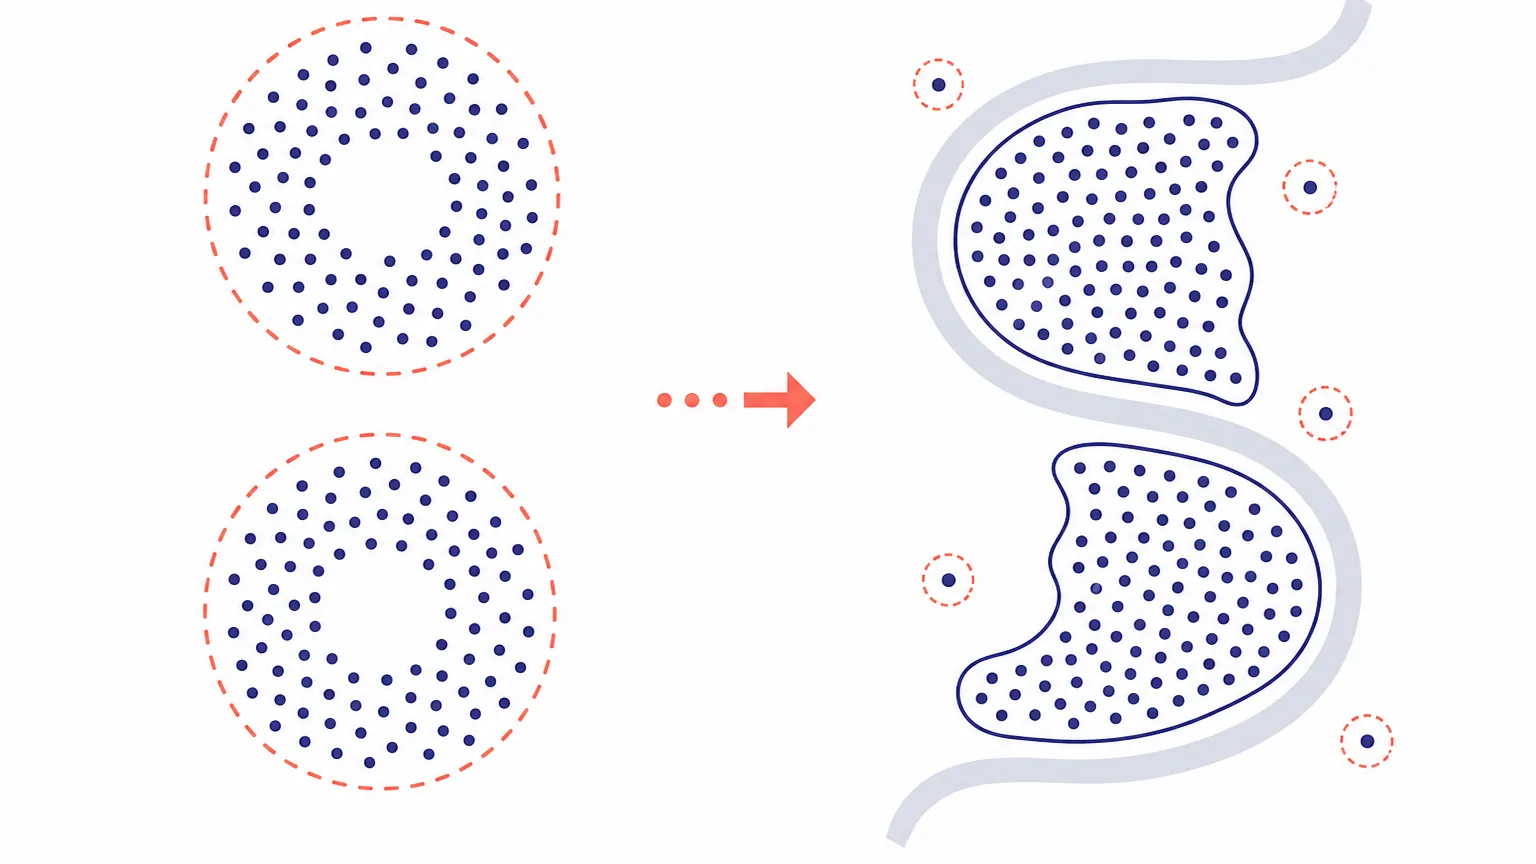
面對高樓密集區與鄉郊村落並存的極端密度差,單一 eps 會陷入市區連成巨型單一群、鄉郊全被判定為雜訊的窘境。HDBSCAN 引入層次化密度估計,只需給定最小群規模參數(min_cluster_size),大幅提升在變密度空間下的穩定性;OPTICS 則能產出可達性圖,是觀察空間密度斷層的優選工具。
階層式:凝聚層次聚類
由底向上逐步合併鄰近點群,生成樹狀圖結構(Dendrogram)。其優勢在於一次運算即可按不同距離閾值切割出「大區—分區—派送網格」多級嵌套層級。但因其空間複雜度呈二次方級別(O(n²)),十萬筆以上資料通常需要先做空間網格降維分塊。
網格聚合:GeoHash 與 H3
將經緯度坐標空間編碼為離散網格索引(如 Uber 開源的 H3 六邊形系統或矩形 GeoHash)。利用資料庫索引(Group By 前綴)即可在毫秒級完成海量點的空間聚合,適合作為第一道粗粒度篩選,再於各網格內部進行精細密度分群。
| 演算法 | 預設分群數 | 形狀適應與雜訊處理 | 實務適用場景 |
|---|---|---|---|
| K-Means | 需指定 K 值 | 凸面球形;無雜訊機制,對極端點敏感 | 均勻網格粗劃分、百萬級快速粗聚類 |
| K-Medoids | 需指定 K 值 | 凸面球形;中心為實體點,抗噪性強 | 前置倉、自提點選址,要求中心可落實 |
| DBSCAN | 自動由密度推導 | 任意幾何形狀;自動分離雜訊點 | 沿街分佈商圈分析、密度均勻區域分組 |
| HDBSCAN | 自動階層推導 | 不規則幾何形狀;支援多級可變密度 | 核心市區與郊外離島混合的真實業務資料 |
| H3 / 網格 | 由解析度決定 | 正六邊形/矩形;存在邊界人為切割 | 海量資料分桶、底層快速空間統計 |
超參數整定:從幾何統計到業務半徑
在 DBSCAN 中,半徑 eps 的設定不可隨意盲猜。規範的做法是繪製 k-距離圖(k-distance graph):計算每個點至第 k 個近鄰的距離並排序繪圖,選取曲線由平緩轉為急劇攀升的「拐點」作為候選 eps。minPts 通常設定為資料維度的兩倍以上,或依據業務允許的最小分群地址容量而定。
輪廓係數(Silhouette Coefficient)常被用於檢驗分群緊湊度與分離度。該指標在評估 K-Means 這類球形幾何分群時具備參考價值,但對於密度模型極具誤導性。沿街道狹長分佈的緊湊客群,在輪廓係數計算中往往得分偏低。評估密度模型時,應結合 DBCV(基於密度的分群驗證指標)或無監督評估體系。
參數並無放之四海皆準的純數學解,必須對齊業務半徑。例如城市末端即時配送通常以 1.5–3 公里(車程經驗範圍)為作業邊界,自提櫃步行生活圈多設定在 5–8 分鐘步程(約 400–600 米直線距離)。以營運邊界反向約束 eps,分群結果方能具備工程可行性。
坐標以外的空間與業務屬性增強
純幾何坐標聚類僅解決了二維空間鄰近問題。在企業級應用中,需將業務屬性與空間特徵編碼融合:
- 建築權重維度:單棟 40 層商住大廈包含上千戶單位,而一間丁屋僅為單一住戶。若不加權處理,高層建築的需求將被稀釋,模型會被人為拉偏。引入訂單量或單位數作為權重項,可修正幾何重心。
- 行政與物理屏障硬約束:區議會邊界、郵政分區、河流、港灣與快速公路可構建空間阻隔矩陣,在圖計算中設定權重無窮大,禁止演算法跨界歸併。
- 地址文字語義向量:將「大廈名稱」、「屋苑期數」透過文字嵌入轉為語義距離,與歐氏距離加權運算,能解決近距離不同社區的精準切分。
高密度垂直城市中的落地挑戰
在典型高密度城市環境下實施地址聚類,會遭遇幾類特殊的邊界情況:
垂直高度與大廈粒度:同一棟摩天商廈內聚集數百間註冊公司,在平面坐標上完全重疊。直接進行平面密度聚類會產生人為的密度奇異點。實務上應先在「建築物(Building ID)」級別進行點位合併,完成大廈層級空間聚合後,再進入路線與工作量細分。
非規範門牌與鄉村地址:非市區的村屋、丁屋門牌常存在不連續或重複命名現象,地理編碼匹配命中率較低。對此類低精度點應打上標籤,先參與宏觀區域聚合,禁止作為微觀邊界的判定核心。
工商與虛擬註冊地干擾:核心商業區的秘書公司大廈常註冊海量無實體人流的企業地址,若用於線下零售選址或物流派件分群,需事先剔除特定工商類別,避免資源錯配。
分群成果評估與業務驗證體系
評估地址聚類表現需並行採用四類度量指標:
內部幾何指標:Davies-Bouldin 指數(越小越好)、Calinski-Harabasz 指數(越大越好),用於小樣本超參數掃描時快速篩選穩定解。
外部一致性指標:利用調整蘭德指數(Adjusted Rand Index, ARI)或調整互信息(AMI),比對新分群與現有營運網格、法定行政分區的吻合度,監控結構突變。
業務效能指標:統計各群組內地址負載方差、平均配送半徑、組間路網重疊率。若各分群的工作量標準差顯著降低,證明劃分有效提升了營運均衡度。
架構穩定性(Stability):採用 Bootstrap 重抽樣方式對 80% 樣本重複運算,透過 Jaccard 相似係數校驗相同點落入同一群組的機率。若輕微資料擾動便導致分區界線劇烈跳動,該參數組合不可用於實際生產。
隱私合規與去識別化防線
地址資訊與姓名、電話結合屬於敏感個人資料。在香港法例第 486 章《個人資料(私隱)條例》(PDPO)及個人資料私隱專員公署(PCPD)相關合規指引框架下,空間分群若粒度過細,仍存在「重識別化(Re-identification)」風險。若某個分群僅涵蓋單一獨棟鄉郊住宅,該群實質上已具備個資指向性。
工程防護機制包含:強制設定最小群組規模(k-anonymity 原則),對小於安全閥值(如少於 10 戶)的群體執行向上合併或微擾動模糊化;分群展示介面僅輸出聚合後的凸包邊界(Convex/Concave Hull)與統計數值,禁止向無權限端輸出散點精確經緯度;除錯階段對底層落點座標加入隨機高斯噪聲,確保資料流轉符合安全規範。
標準化端到端工程實施路線
- 文字標準化解析:正則提取行政區、路段、號碼及建物名稱,統一繁簡與拼寫異構。
- 坐標對齊與投影轉換:對接可靠地理編碼接口,統一轉換為平面投影坐標系,並寫入匹配等級。
- 異常點隔離過濾:剔除海域、荒原及境外等離群坐標,標記低精度點。
- 空間網格降維分塊:藉由 H3 或 GeoHash 完成初級分組,將運算複雜度降至單一網格內。
- 參數掃描與模型運算:繪製 k-距離圖確定候選半徑,依業務需求執行 HDBSCAN 或帶權 K-Medoids。
- 拓撲與業務約束後處理:施加天然屏障阻隔,強制切分跨海與跨山群體,併入過小碎片群。
- 業務指標驗收與發布:比對工作量均衡度與路網成本,生成邊界凸包並建立定期重跑排程。
常見問題解答(FAQ)
Q1:為什麼不能直接拿經緯度計算歐氏距離(Euclidean Distance)做聚類?
經緯度本質是角度而非平面距離。在非赤道區域(如北緯 22 度附近),經度方向的 1 度所對應的物理地表長度約為緯度 1 度的 92.5%。若直接將經緯度數值代入歐氏距離公式,會造成東西方向的距離權重被結構性低估,產出向東西兩側拉長的不對稱幾何分群。在大規模運算前,必須先轉換為局部平面投影坐標系(如米制網格)或改用球面大圓公式。
Q2:DBSCAN 和 K-Means 在處理地址分群時最大的區別是什麼?
K-Means 必須預先由人工指定群組數量 K,其假設群體呈規則的均勻球形,且強迫每個點都必須歸屬於某個群,極易將幾何中心算在水體或無人區。DBSCAN 是基於密度的模型,無需預設群數,能識別沿街道蜿蜒的任意複雜形狀,更具備天然的雜訊過濾機制,能自動將地址錯誤或極端偏遠的點分離出來,防止邊界被異常值拉歪。
Q3:海量地址資料在進行聚類運算時記憶體不足或速度太慢,如何優化?
最實用的工程做法是引入「空間分層」機制。首先利用 H3 六邊形或 GeoHash 空間索引將幾十萬級別的資料劃分到二級宏觀網格內,完成快速空間分桶;接著在各個網格內部建立 Ball Tree 空間索引樹以加速近鄰檢索;最後針對各區域局部並行運算密度聚類。這種架構能將時間複雜度顯著降至線性對數級,避免計算全域兩兩點對矩陣帶來的記憶體崩潰。
Q4:如何防止聚類演算法劃分出跨海或跨越山脈的不合理派送分區?
單靠二維直線距離必然會出現跨海或跨越高速公路的錯誤群組。解決方法有三種層次:第一種是在後處理階段,以天然水體與行政邊界作為多邊形「阻隔線」,強制切分跨界群;第二種是在特徵工程中採用兩階段策略,以粗聚類候選點調用路網路由矩陣(Routing Matrix),以實際車程時間取代直線距離;第三種是構建受約束的空間鄰接圖,將跨海兩點間的邊權重直接設定為無窮大。



