
The task requires specific formatting constraints. The response must begin with direct text, avoiding titles or quoted statements. It should conclude with a FAQ section. **Important content** will be highlighted in **light blue**. The website’s theme color, **light blue**, needs to be incorporated.
Here’s the FAQ:
**FAQ:**
* **Can the response start with a title?** No, the response must begin with a regular paragraph.
* **What should be included at the end?** The response should conclude with a FAQ section.
* **How should important content be marked?** Important keywords should be bolded and in light blue.
* **What should the theme color be?** The theme color should be light blue.
比特幣節點日誌查看對於診斷同步問題和 P2P 連線異常至關重要。 預設的 `debug.log` 檔案記錄了節點的各種活動,但預設 `info` 級別可能不包含所有網路層面的詳細信息。 為了深入分析,可能需要啟用額外的調試選項,如 `-debug=net` 或 `-loglevel=net:debug`,以捕獲諸如**P2P** 連線超時、斷開連線、握手失敗或 misbehaving 節點等事件。
**FAQ:**
* **如何查看比特幣節點的日誌?** 檢查節點運行的目錄下的 `debug.log` 檔案。
* **預設的日誌級別是否足夠?** 預設 `info` 級別可能不包含所有網路層面的信息,需要根據情況調整。
* **如何啟用更詳細的日誌?** 啟動節點時,使用 `-debug=net` 或 `-loglevel=net:debug` 參數。
節點運行時間一長,debug.log 便成為最真實的底層運行紀錄。無論是磁碟寫入延遲、對等節點在握手階段中斷、區塊下載逾時遭剔除、UTXO 快取滿載強制刷盤,或是記憶池湧入異常手續費交易,所有事件都會在此留下軌跡。面對動輒數百 MB 的日誌內容,掌握精確的比特幣節點日誌查看方法,是快速定位同步延遲與 P2P 連線故障的核心技能。
排查問題的標準流程非常清晰:先確認日誌路徑與輸出級別,接著從 UpdateTip 關鍵行掌握區塊鏈尖端(Tip)的推進節奏,最後針對 P2P 網路層的警告與錯誤訊息進行交叉診斷。各版本 Bitcoin Core(如 v24 至 v27 等現代版本)在具體措辭與欄位順序上可能略有微調,範例中所列之區塊高度、雜湊值與快取數值均為結構示意,實際除錯時請以運行環境的真實輸出為準。
確認 debug.log 路徑與預設記錄原則
Bitcoin Core 的日誌檔案預設存放於資料目錄(Data Directory)中:
- Linux:
~/.bitcoin/debug.log - macOS:
~/Library/Application Support/Bitcoin/debug.log - Windows:
%APPDATA%\Bitcoin\debug.log
如果採用獨立硬碟存放區塊鏈資料,或希望減輕主硬碟的 I/O 競爭,可在啟動時透過參數 -debuglogfile=/path/to/debug.log 指定路徑。這在除錯測試節點時特別方便,能將測試日誌與生產環境徹底隔離。
日誌時間戳統一採用 ISO 8601 標準的 UTC 時間格式(如 2026-05-07T08:12:44Z)。排查時需注意本地時區轉換(例如 UTC+8 環境比日誌時間快 8 小時),避免誤判為系統時鐘偏差。真正決定同步狀態的,是日誌時間戳與區塊標頭自帶時間(date)的差距。
值得注意的是,預設設定下的 debug.log 僅記錄 info 級別以上的全局資訊(如 UpdateTip)。若未特別設定,底層詳細的網路傳輸與握手事件不會全部寫入,這是避免硬碟空間在短時間內被海量日誌耗盡的保護機制。
日誌類別與除錯層級調配
要深入分析連線異常,必須手動開啟特定類別的日誌。常用的調控參數包含:
-debug=類別:提升指定類別至 debug 級別(例如-debug=net)。-debugexclude=類別:過濾指定類別的高頻冗餘訊息。-loglevel=類別:級別:精細指定層級,例如-loglevel=net:debug或全域設定-loglevel=debug。
追蹤同步延遲與 P2P 異常時,核心類別主要為 net(網路通訊)、validation(區塊驗證)、addrman(對等節點位址管理)以及 blockstorage(區塊磁碟存儲)。排查交易傳播可額外開啟 mempool,排查 API 請求則啟用 http。
注意事項:初次區塊下載(IBD, Initial Block Download)階段切勿將所有類別全開至 trace 或 debug 級別。巨量日誌寫入會嚴重消耗磁碟 I/O,甚至拖慢驗證進度。常規排查僅需配置
-loglevel=net:debug與validation:info即可取得足夠資訊。
解讀 UpdateTip:洞悉節點同步節奏
在進行比特幣節點日誌查看時,最有價值的關鍵輸出就是 UpdateTip。每當節點成功連接並驗證新區塊,就會寫入一行摘要紀錄:
2026-05-07T08:12:44Z UpdateTip: new best=00000000000000000002f1a... height=880123 version=0x20000000 log2_work=95.14 tx=1123456789 date='2026-05-07T08:08:03Z' progress=0.999987 cache=214.6MiB(1012345txo)
各欄位所代表的系統含義如下表所示:
| 欄位名稱 | 欄位含義 | 異常診斷要點 |
|---|---|---|
| height | 當前最佳鏈尖區塊高度 | 長期停滯代表未下載或驗證卡死;區塊鏈重組(Reorg)時可能出現短暫回退 |
| date | 該區塊標頭中的出塊時間戳 | 與日誌開頭時間戳的差距代表實際落後區塊鏈的時間長度 |
| progress | 整體驗證進度估算值 | 基於累積工作量估算,同步完成前常停在 0.999…,精準狀態應查詢 RPC 的 initialblockdownload 欄位 |
| log2_work | 當前鏈累計工作量的以 2 為底對數 | 最佳鏈工作量只會單調遞增;重組切換至新鏈時數值仍會增加 |
| cache | 記憶體中尚未寫盤的 UTXO 快取大小 | 持續接近 -dbcache 設定值時會頻繁觸發 FlushStateToDisk 刷盤 |
| tx | 全鏈累積已驗證交易總數 | 僅在鏈重組切換分支時數值可能微幅變動 |
實例判斷:若日誌時間戳為 08:12(UTC),區塊 date 為 08:08(UTC),落後 4 分鐘屬於主網正常廣播傳播延遲;若日誌時間戳已是當日,而最新 UpdateTip 的 date 停留在兩天前,則說明節點同步存在實質停擺。
log2_work 變化特性
log2_work 代表節點認可的最佳有效鏈總工作量。根據最長鏈(最大工作量鏈)規則,此數值具備單調遞增性。發生鏈重組時,區塊高度 height 可能回退數個區塊並重新攀升,但 log2_work 仍會持續增長。如果觀察到高度回退而 log2_work 反常下降,則應深入檢查節點是否載入了無效的無效分支設定(invalidateblock)。
辨別「處理緩慢」與「徹底停滯」
日誌滾動不代表區塊同步正在推進。可使用命令間隔檢查 UpdateTip 產生頻率:
grep -c "UpdateTip" ~/.bitcoin/debug.log
搭配 RPC 指令 bitcoin-cli getblockchaininfo 中的 initialblockdownload 布林值確認。若該值為 false 且 UpdateTip 定期更新,代表節點已處於同步尖端;若該值為 true 但計數長時間未增加,則需進一步排查網路或磁碟瓶頸。
同步延遲的常見日誌特徵
1. 節點連線品質低落或連線不足
在啟用 -debug=net 情況下,若頻繁出現節點連線建立後隨即斷開的循環,日誌中會充斥連線狀態變更。透過 bitcoin-cli getnetworkinfo 查看,若 connections_in 始終為 0,說明節點處於 NAT 或防火牆後方,無法接收外部入站連線,完全依賴 8~10 個出站連線,一旦出站節點延遲過高,同步速度將明顯受阻。
2. 磁碟寫入與 UTXO 刷盤瓶頸
當 UTXO 快取飽和時,節點必須將狀態寫入 LevelDB 磁碟資料庫。日誌中會出現 FlushStateToDisk 或寫盤耗時過長的紀錄。在傳統機械硬碟或低效能 SATA SSD 上,單次刷盤可能耗費數秒甚至數十秒,期間所有區塊驗證均會暫停。
3. 區塊下載逾時(需啟用 -debug=net)
2026-05-07T08:31:02Z Timeout downloading block 0000000000000000000a7c... from peer=12, disconnecting
2026-05-07T08:31:02Z Disconnecting peer=12
此訊息表示向特定節點請求區塊資料未能在超時窗口內獲得回應,節點主動切斷連線並轉向其他對等節點索取。偶發出現屬於 P2P 網路正常自我保護行為;若在同一高度針對多個節點連續超時,則表明本地出口頻寬被佔滿或 TCP 長連線遭中間網路設備重置。
4. 鏈尖停滯警告(Potential stale tip detected)
2026-05-07T09:04:18Z Potential stale tip detected, will try using extra outbound peer (last tip update: 427 seconds ago)
當節點超過一定時長(通常約 7 條出塊時間窗口,400~600 秒)未收到新區塊時,會觸發此警告並主動發起額外的出站連線以尋求最新鏈尖。連續出現此訊息意味著節點可能遭遇網路分區隔離或對等節點品質嚴重惡化。
P2P 網路層異常日誌型態解析
深入追蹤對等節點行為時,請確保已配置 -debug=net 或 -loglevel=net:debug,以捕獲完整的網路事件:
握手階段逾時(version handshake timeout)
TCP 連線建立後,對方未在指定時效內發送 version 封包完成協議握手。原因多為公網掃描器探測、代理節點失效或高延遲網路丟包。此類訊息通常作為背景雜訊處理,無需過度干預。
連線重置(Connection reset by peer)
2026-05-07T08:47:55Z socket send error Connection reset by peer (104)
2026-05-07T08:47:56Z socket recv error Connection reset by peer (104)
底層 Socket 遭對端或中繼路由器發送 TCP RST 封包強行中斷。若在短時間內大規模爆發,應檢查本地 NAT 路由器連線追蹤表(Conntrack Table)是否已滿,或網路電信商是否針對長期 P2P 連線進行了阻斷。
協議違規與評分驅逐(Misbehaving)
當對端節點發送無效區塊、格式錯誤交易或違反共識訊息時,Bitcoin Core 的 DoS 防禦模組會記錄 Misbehaving: peer=... 並給予扣分。累積達到閾值後將被主動斷開並列入暫時封鎖名單。這屬於常態防護,證明節點防禦機制正精確運作。
結合 RPC 指令進行即時交叉診斷
單看日誌是事件流,配合 RPC 快照能夠更精準鎖定異常對等節點。常用指令如下:
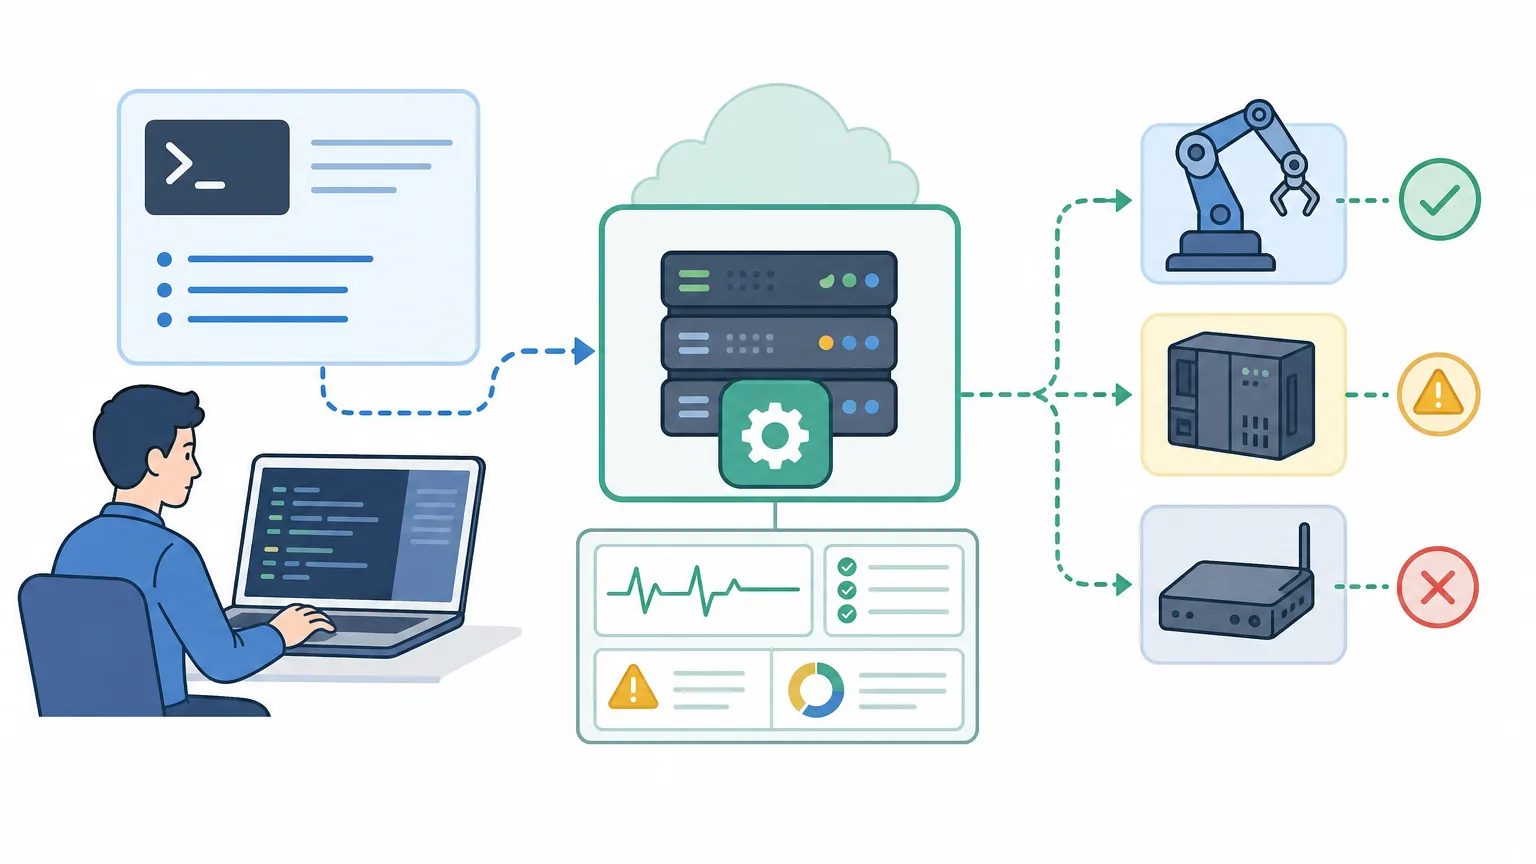
bitcoin-cli getpeerinfo | jq '.[] | {id, addr, subver, pingtime, pingwait, bytessent, bytesrecv, lastsend, lastrecv, connection_type, inbound}'
重點交叉比對欄位包括:
- pingtime:正常節點一般介於 0.02 至 0.3 秒之間,若持續數秒以上代表傳輸路徑品質不佳。
- pingwait:若該欄位存在非零數值且長期未清除,說明 Ping 請求尚未獲得回應,該連線已陷入半死鎖狀態。
- bytesrecv / bytessent:連續多次查詢,若某個對等節點的傳輸量完全無變化,代表其未對當前區塊同步產生貢獻。
- connection_type:識別連線形態。例如
block-relay-only節點僅轉發區塊而不廣播交易記憶池內容,排查交易同步時應注意區分。
高效追蹤與統計除錯命令
在伺服器端進行比特幣節點日誌查看時,掌握精準的 Shell 管道指令可大幅提升效率:
# 1. 即時監控區塊同步進度(相容 GNU/BSD 環境)
tail -f ~/.bitcoin/debug.log | grep --line-buffered "UpdateTip"
## 2. 即時過濾連線警告與異常斷開
tail -f ~/.bitcoin/debug.log | grep -Ei --line-buffered "disconnect|timeout|misbehaving|stale tip|socket"
## 3. 精確統計當日(UTC)各類錯誤與警告次數
grep "^$(date -u +%Y-%m-%d)" ~/.bitcoin/debug.log | grep -Ei "timeout|reset by peer|misbehaving" | sed -E 's/.*(Timeout|reset by peer|Misbehaving).*/\1/' | sort | uniq -c | sort -rn
若節點交由 systemd 託管,可使用 journalctl -u bitcoind -f -o short-iso 進行系統層級事件的時間軸對齊,便於核查節點程序是否曾遭遇 OOM(Out of Memory)記憶體溢出終止或硬碟 I/O 報錯。
日誌輪替維護與隱私安全脫敏
Bitcoin Core 本身不自帶自動切分日誌機制,長期運行下檔案會無限制擴展。近代 bitcoind 程序會持續鎖定 debug.log 的檔案描述符(File Descriptor),若直接使用 mv 指令重新命名,程序將繼續寫入原有的 Inode,導致新檔案無法記錄。
推薦採用系統層級的 logrotate 搭配 copytruncate 模式,或在例行重啟維護時進行歸檔。針對已被 gzip 壓縮的歷史日誌檔案(如 debug.log.1.gz),應使用 zgrep 進行直接檢索。
隱私警告:debug.log 中包含節點所連線的所有外部節點 IP 位址、本地廣播時間及出站拓撲結構。在將日誌公開張貼至論壇或社群尋求技術協助前,務必使用文字處理工具將公網 IP 及錢包 RPC 紀錄進行遮蔽脫敏。
常見日誌診斷速查表
| 日誌特徵字串 | 前置日誌級別 | 事件性質與診斷建議 |
|---|---|---|
| UpdateTip 推進中斷 | 預設(info) | 區塊驗證或下載停滯,檢查 UTXO 快取及連線數 |
| Timeout downloading block | -debug=net | 對端區塊傳輸逾時;頻繁出現需檢查本地網路頻寬與防火牆 |
| Potential stale tip detected | 預設(info) | 長時未接收到新區塊,節點嘗試建立額外出站連線 |
| socket send/recv error (104) | -debug=net | TCP 連線被對端或中間路由重置,注意觀察產生頻率 |
| version handshake timeout | -debug=net | 協議握手逾時,多為失效位址池或掃描探測,無需介入 |
| Misbehaving: peer=… | -debug=net | 對端違反 P2P 協議已扣分,屬於節點主動防禦機制 |
| FlushStateToDisk 耗時過長 | -debug=bench 或 validation | 磁碟 I/O 效能受限,建議提升 dbcache 或更換 NVMe 固態硬碟 |
關鍵參數優化方向
根據日誌診斷出的瓶頸類型,可有針對性地調整節點啟動配置:
- -dbcache=<n>:設定 UTXO 集合在記憶體中的快取上限(單位 MiB)。在記憶體充裕的環境(如 16GB RAM),於 IBD 期間配置
-dbcache=4096或更高,可大幅降低 FlushStateToDisk 刷盤頻率。 - -maxconnections=<n>:調整全節點允許的最大連線數(預設 125)。若網路頻寬有限且日誌中存在大量握手超時,適當降低該值可減輕網路擁塞。
- -maxuploadtarget=<n>:設定每日對外資料上傳流量上限(例如
-maxuploadtarget=5000表示每日約 5000 MiB),防止節點在上行頻寬耗盡時影響新區塊的正常接收。 - -blocksonly:開啟後節點僅接收並驗證新區塊,不再轉發及維護未確認交易記憶池,適合極度受限環境下的純驗證用途。
常見問題(FAQ)
Q1:為什麼在 debug.log 中看不到 Timeout downloading block 或 Misbehaving 等錯誤?
A:Bitcoin Core 預設僅輸出 info 級別的總體日誌。涉及 P2P 網路層詳細連線、超時及節點懲罰的訊息屬於 net 類別的 debug 級別。必須在配置檔中加入 debug=net 或啟動時帶上 -loglevel=net:debug 參數後,相關日誌才會寫入檔案。
Q2:UpdateTip 裡的 progress 長時間停在 0.9999xx,是代表節點卡住了嗎?
A:不是。progress 是依據累積工作量進行的數學估算值。由於歷史區塊工作量龐大,當節點同步到最新鏈尖時,該數值通常會維持在 0.9999 附近。精準判斷標準應執行 bitcoin-cli getblockchaininfo,只要 initialblockdownload 顯示為 false,且 UpdateTip 的 date 與本地 UTC 時間相差在常規出塊間隔內,節點即處於健康的最新同步狀態。
Q3:日誌中出現高度 height 回退,是發生鏈分叉攻擊了嗎?
A:通常只是正常的區塊鏈小幅度重組(Reorg)。當不同礦工在相近時間挖出區塊時,網路上會短暫存在競爭鏈;一旦某條鏈累積了更多工作量,節點會自動回退並切換至更長鏈。只要日誌中的 log2_work 保持單調遞增,就屬於比特幣 Nakamoto 共識機制的標準運作流程。



