
比特幣全節點的隱形成本,藏在上傳頻寬裡
2016 年 Bitcoin Core 0.13 把 BIP 152 帶進主網之後,全節點的網絡開銷出現過一次明顯的階梯式下滑。當時社群的討論焦點多半放在「區塊傳播更快、孤塊率更低」,但對長期維護節點的人來說,實際的轉變在於:一個裝滿交易的區塊,不再需要原封不動地從對方手上整包下載並重複轉發。
這項機制決定了普通硬體與家用線路能否持續運行一個全節點。緊湊區塊節省頻寬的意義在於,當大部分交易資料可以靠本地記憶池(Mempool)自行拼裝補齊時,節點的下行與上行壓力便從隨鏈上交易線性膨脹,轉為相對平穩的狀態。這種頻寬門檻的控制,直接牽動著全網節點的數量、地理分佈與真實的去中心化程度。
許多營運者在初次同步(IBD)完成後,常會面臨持續性的對外上傳流量壓力。特別是在開啟完整中繼、維持多條連線的家用或小型雲端主機上,若缺乏有效的壓縮廣播機制,持續的區塊轉發會迅速耗盡線路配額。緊湊區塊透過只傳輸交易索引的方式,大幅降低新區塊廣播時的資料量,讓低頻寬環境的節點能維持與全網同步。
緊湊區塊的核心邏輯:拆解已知與未知集合
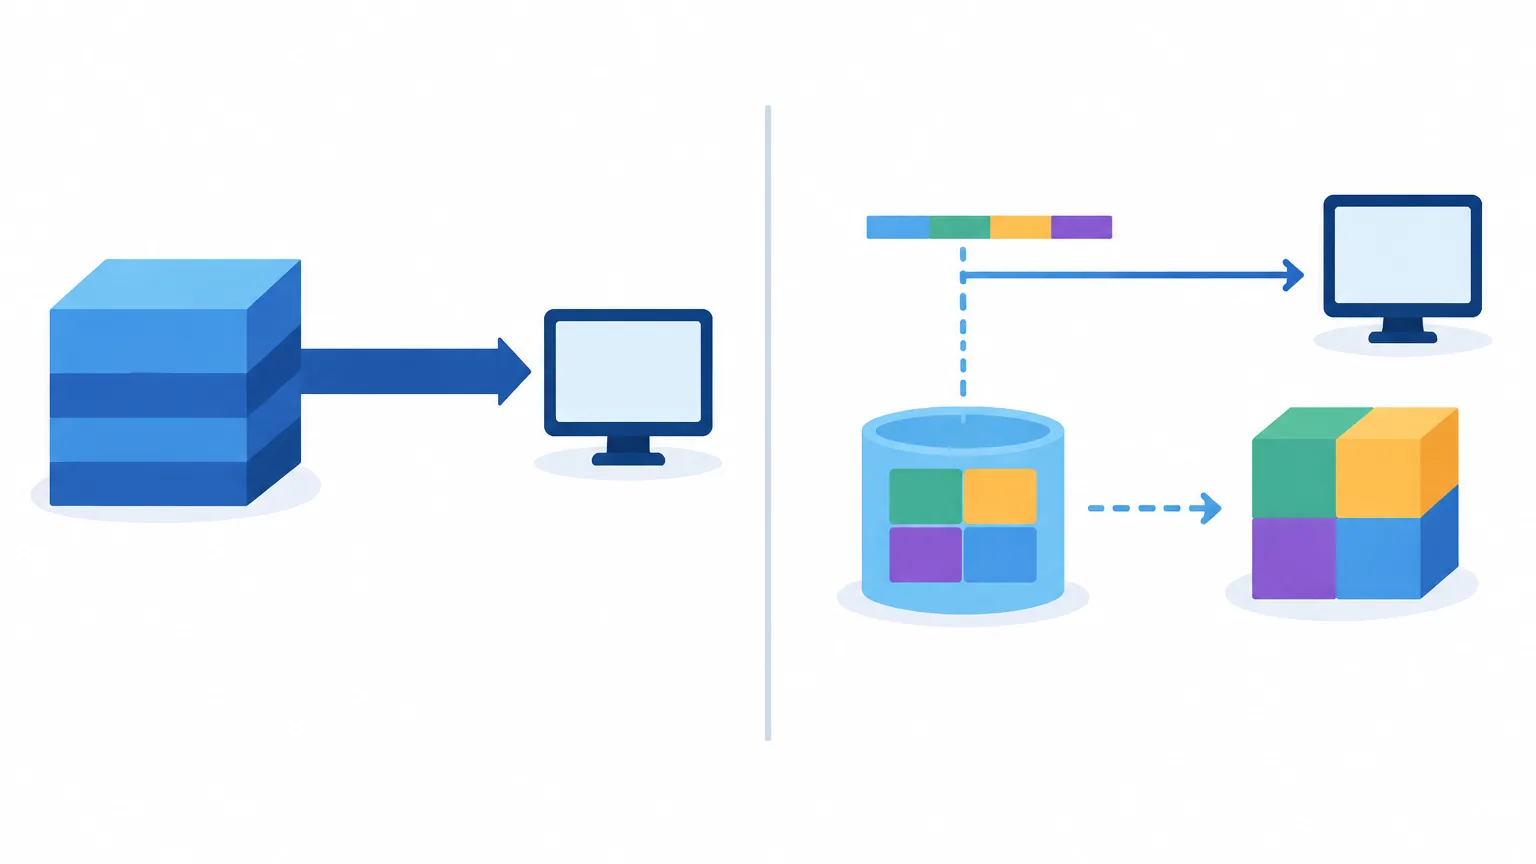
傳統的區塊傳輸機制中,接收方在收到區塊公告後請求資料,發送方會將 1 MB 至 2 MB 以上的完整區塊序列化位元組流直接發送。然而,區塊內的大多數交易早在被打包前就已經透過 P2P 網絡廣播至各個節點的記憶池中,這種整包傳輸造成了嚴重的頻寬浪費。
BIP 152 改變了這一流程:發送方改為傳送一個 cmpctblock 訊息,其核心內容包含區塊頭、每筆交易經過雜湊計算後的短標識(Short ID,每個佔 6 位元組),以及部分發送方預測接收方可能尚未持有的交易(如 Coinbase 交易)。接收方利用本地記憶池對比 Short ID,還原出完整區塊;僅在遭遇缺失時,才透過 getblocktxn 與 blocktxn 補齊差集。
Short ID 的算術原理
短標識的生成依據 BIP 152 規範文件,採用以區塊頭雜湊與隨機數組合為金鑰的 SipHash-2-4 運算,並截斷取前 6 位元組。以一個包含 2,500 筆交易的標準區塊估算,2,500 × 6 位元組約為 15 KB,加上區塊頭(80 位元組)及必要的預填交易,在本地記憶池吻合度極高的理想狀態下,傳輸資料量可壓縮至幾十 KB,顯著降低即時頻寬佔用。
緊湊區塊節省的是重複傳輸開銷,而非本地驗證成本。 節點在還原區塊後,依然需要對交易簽章、UTXO 變更與工作量證明進行完整的 CPU 與磁碟 I/O 驗證,計算負擔並未減少。
高頻寬模式與低頻寬模式的運作差異
BIP 152 定義了兩種中繼模式。高頻寬模式(High-Bandwidth Mode, HB)允許對等節點在驗證區塊有效後,無須等待請求即主動推送 cmpctblock,省去一個網絡往返時間(RTT);低頻寬模式(Low-Bandwidth Mode, LB)則遵循先宣告區塊頭、後由接收方主動拉取的流程。
在 Bitcoin Core 的預設實作中,HB 模式通常僅對少數幾個對等節點(預設上限通常為 3 個)啟用,以防止出塊瞬間多個節點同時推送造成突發性入站頻寬壅塞。LB 模式則用於其餘連線,確保整體流量平穩。
| 比較項目 | 高頻寬模式(HB) | 低頻寬模式(LB) |
|---|---|---|
| 觸發機制 | 發送方主動推送 cmpctblock | 接收方收到公告後發起請求 |
| 額外往返延遲(RTT) | 0 次額外往返 | 1 次往返(請求區塊) |
| 連線啟用限制 | 限制為少數連線(實作通常約 3 條) | 可支援其餘常規對等連線 |
| 適用場景 | 礦池、低延遲傳播中繼 | 家用節點、計費受限 VPS |
| 瞬時頻寬特徵 | 出塊瞬間易產生流量峰值 | 傳輸時間稍微平攤,避免突發 |
節點營運的頻寬壓力與設定盲點
評估全節點成本時,儲存空間屬於一次性採購的固定硬體投入(目前比特幣未剪裁全節點資料目錄約數百 GB 量級),但頻寬是每月持續產生的維運開銷。在計費雲端環境或非對稱寬頻(如上傳受限的家用網路)中,流量控制往往是決定節點能否長期運行的關鍵。
流量異常增長的原因排查
若節點營運者發現上傳流量顯著偏離常態,常見的技術原因包括:
- 緊湊區塊重建頻繁失敗:若本地節點記憶池設定過小、頻繁重啟或對等節點記憶池差異過大,會導致 Short ID 比對失敗率上升,被迫退回索取大量完整交易或直接下載完整區塊。
- 歷史區塊中繼負擔:緊湊區塊僅對即時出塊廣播有效。若節點對外開放連線,且頻繁響應其他新加入節點的初次同步請求,歷史區塊的傳送仍需傳輸原始完整資料。
- 未限制對等連線數:過多的入站連線(Inbound Connections)會成倍放大未確認交易(Unconfirmed Transactions)的廣播與重複中繼量。
對網絡去中心化與傳播特性的實際影響
緊湊區塊節省頻寬的工程改進,在多個維度對網絡拓撲產生深遠影響:
降低地理偏遠與家用節點的邊緣化風險
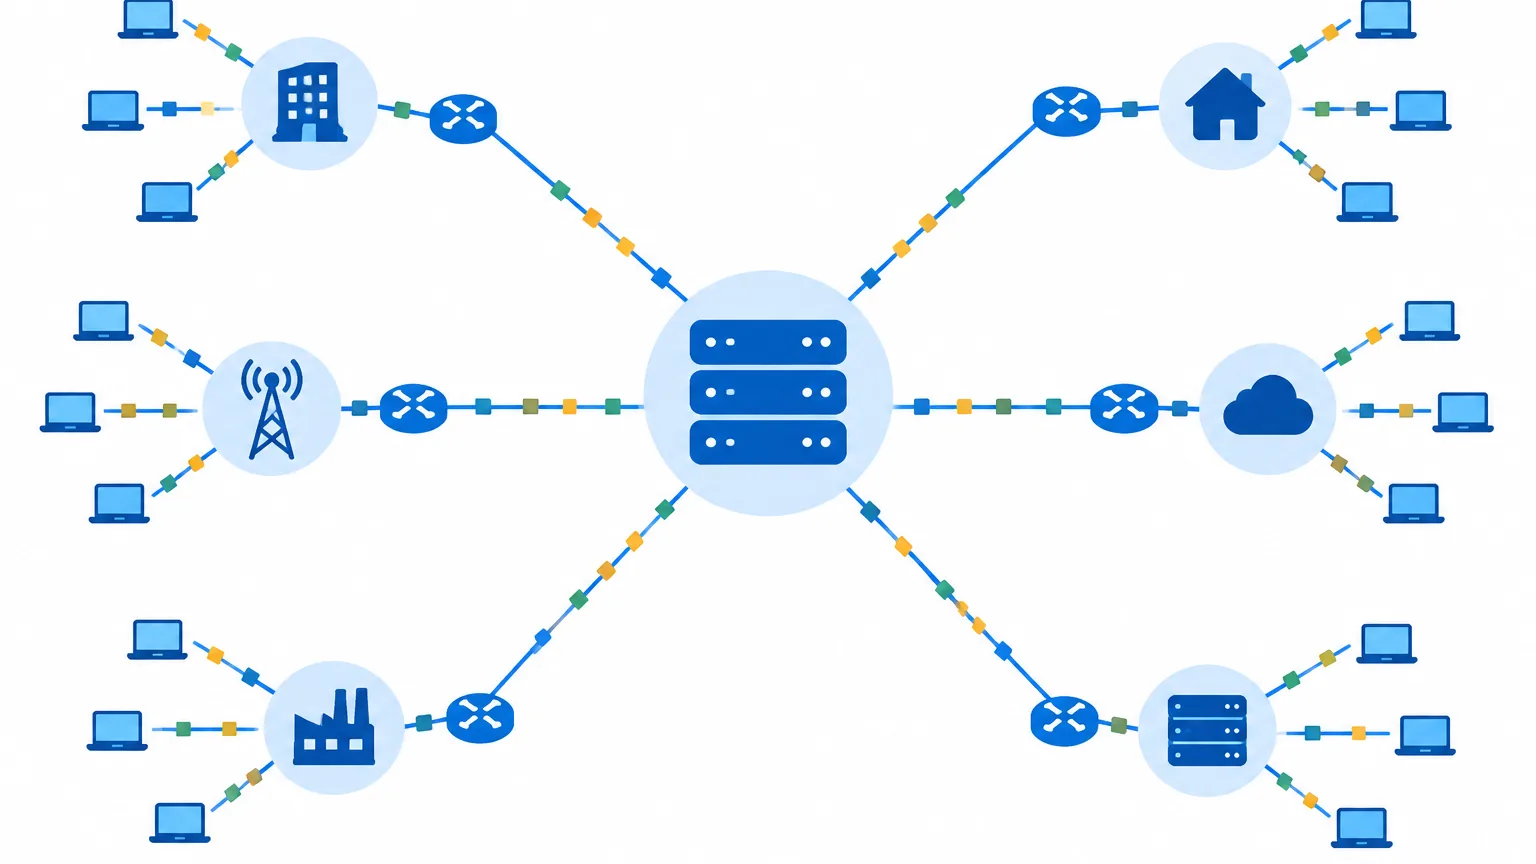
在頻寬成本較高或跨洲網路延遲較大的地區,若區塊廣播必須傳送完整 MB 等級的資料,偏遠節點將始終處於資訊滯後狀態。透過將區塊廣播的核心資料壓縮至數十 KB,網絡邊緣節點能以接近主幹網路的速度獲知最新區塊頭與交易組合,大幅縮小因物理距離帶來的同步落差。
降低孤塊率與算力集中風險
在礦池端,區塊傳播延遲與孤塊率(Orphan Rate)呈正相關。當出塊資訊傳播緩慢時,大型礦池憑藉內部網絡與直連優勢,能更早開始下一區塊的計算,小型礦池則面臨更高的算力無效耗損風險。緊湊區塊顯著壓縮了傳播耗時,使全網算力處於更公平的競爭環境,間接減緩了算力向少數超大型實體集中的趨勢。
壓縮機制的失效情境與邊界條件
緊湊區塊的高效運作高度依賴網絡節點間的記憶池同構性。在以下情境中,壓縮效率會顯著退化:
- 包含私有交易或非標準交易:若礦工打包了未經公網廣播的私有加速交易或特殊交易,接收節點必然缺乏這些交易本體,必須透過額外的往返請求完整內容。
- 節點剛重啟:剛重啟的節點記憶池為空,需要時間重新監聽並累積未確認交易。此時若收到新區塊,緊湊區塊還原必定失敗,只能回退至完整下載模式。
- 短標識碰撞(Short ID Collision):雖然 6 位元組 SipHash 發生碰撞的機率極低,但若發生對應衝突,節點將無法明確匹配交易,亦需向對等節點發起額外請求。
延伸演進:未確認交易中繼與跨鏈壓縮思路
緊湊區塊解決了「已確認區塊」的廣播重複問題,但日常 P2P 網絡中更大的持續開銷來自「未確認交易(Mempool Transactions)」的泛洪廣播(Flooding)。
交易中繼優化(Erlay / BIP 330)
為了解決未確認交易逐條公告帶來的頻寬浪費,社群提出了以集合協調(Set Reconciliation,如 Minisketch 演算法)為基礎的方案。這套機制記錄在 BIP 330 規範文件 中,其核心理念是讓相鄰節點定期比對交易集合的差異指紋,僅傳輸雙方手頭缺失的交易,期望大幅降低交易宣告時的重複頻寬佔用(該機制目前仍處於標準演進與逐步整合階段)。
其他公鏈的頻寬優化路徑對比
- 以太坊 Blob 交易(EIP-4844):根據 EIP-4844 規範文件,以太坊將大量 Rollup 資料移至共識層 Blob 中傳播,並設定短期保存期限(約 4,096 個 Epoch,約 18 天),避免主鏈執行層節點永久承擔龐大的歷史資料存儲與中繼頻寬。
- Solana Turbine:借鑑 BitTorrent 機制,將區塊拆分成微小的碎片(Shreds),並利用樹狀拓撲結構進行多層轉發,避免由單一出塊節點向所有驗證節點進行單點廣播。
節點營運者的頻寬優化實務清單
對於希望在有限網絡預算下穩定運行節點的營運者,建議參考以下設定排查與調優清單:
- 檢查日誌確認緊湊區塊正常運作:透過指令
bitcoin-cli getpeerinfo檢查連線狀態中的bytessent_per_msg與bytesrecv_per_msg,確認cmpctblock佔主要中繼流量,而非頻繁退回完整block訊息。 - 配置記憶池保留空間:在
bitcoin.conf中保持合適的maxmempool(預設通常為 300 MB),避免過小的記憶池導致交易缺失從而引發區塊重構失敗。 - 限制出站上傳總量:若處於按流量計費的 VPS,可設定
maxuploadtarget=<MiB/day>,當每日上傳觸及閾值時,節點會自動停止中繼歷史區塊,僅保留最基本的即時區塊廣播。 - 適度調節最大連線數:透過
maxconnections=<n>控制節點總連線數量,可顯著抑制交易公告帶來的重複上傳壓力。 - 非必要避免頻繁重啟:排程維護應儘量安排在鏈上交易離峰期,減少清空記憶池對緊湊區塊命中率的短期負面影響。
常見問題解答(FAQ)
Q1:緊湊區塊是否需要節點額外手動設定才能啟用?
不需要。在現代主流的 Bitcoin Core 版本中,BIP 152 緊湊區塊支援是預設開啟的基礎通訊協定。節點在與對等節點完成握手後,會自動協商並啟用適當的緊湊區塊模式。
Q2:使用剪裁節點(Pruned Node)會影響緊湊區塊的節省效果嗎?
不會。剪裁節點僅會定期刪除硬碟中的過期歷史區塊,其記憶池(Mempool)功能與對新區塊的驗證流程依然完整運行,因此在新區塊的接收與廣播上,緊湊區塊的壓縮節省效果完全一致。
Q3:為什麼開啟了緊湊區塊,節點的每月上傳流量仍然很高?
緊湊區塊主要優化新區塊廣播時的頻寬。節點的整體上傳流量通常還受到未確認交易泛洪廣播(Tx Relay)以及響應其他節點初次同步請求(歷史區塊下載)的影響。若需要嚴格限制總流量,應搭配 maxuploadtarget 或限制連線數等參數使用。
Q4:短標識(Short ID)如果遇到雜湊碰撞會發生什麼事?
BIP 152 規範中設計了完善的防錯處理。若接收節點在解碼過程中發現本地記憶池有多筆交易匹配同一個 Short ID(即發生碰撞),或者無法正確拼裝區塊,節點會自動向發送方發送 getblocktxn 請求獲取完整交易,最壞情況下直接回退至傳統完整區塊傳輸,不會影響區塊鏈狀態的正確性與安全性。



