
寫過自動化腳本的工程師大多遇過同一個場景:一段最初僅有數十行的流程,經過數次需求迭代後膨脹為數百行,內部交織著深層嵌套的 if-else 判斷、零散的例外捕捉與臨時修補邏輯。任務目標本身並未本質變更,失控的是描述與協調任務的方式。將線性平鋪的執行順序改寫為由節點與邊構成的樹狀結構,使每個步驟的職責、依賴關係、錯誤補償機制與輸出作用域皆具備獨立邊界,由執行引擎依拓撲結構展開——這正是MAST 腳本樹應用所對應的核心工程架構思維。
在工程術語層面,公開文獻中並無統一的專有名詞定義何謂 MAST 腳本樹。MAST 本身在多個技術領域具備不同縮寫意涵,在自動化與流程編排脈絡下,通常指代以樹狀結構建模腳本執行流程的工程實踐。其底層依賴的結構語意、控制流遍歷與狀態隔離機制,均可對應至現代工作流引擎(如 BPMN 標準)與分散式交易架構(如 Saga 模式)。
先釐清 MAST 在不同領域的指涉
檢索相關技術關鍵字時,常見幾種容易混淆的概念。將其並列辨析有助於準確界定討論範疇:
- 比特幣 Merkle 抽象語法樹(Merkelized Abstract Syntax Tree):依據 Bitcoin Optech 的 MAST 專題說明,該機制將多個互斥的支出條件構建為 Merkle 樹,交易花費時僅需揭露實際觸發的分支路徑。這是密碼學與分散式帳本中針對腳本體積壓縮與隱私提升的具體設計。
- 天文數據檢索介面(Mikulski Archive for Space Telescopes):依據 STScI MAST API 規範,其為太空望遠鏡觀測數據的程式化存取介面,屬於標準 REST/Web API 應用。
- 通用自動化工程中的腳本樹架構:作為內部系統或特定自動化平台架構名詞時,指將自動化任務(如 RPA、資料採集、整合測試)抽象化為包含條件分流、並行發散與失敗補償的層級化樹狀執行圖。
Merkle 腳本樹與工作流腳本樹的核心差異
雖然兩者在結構直覺上均採用「不執行全量邏輯、僅展開有效分支」的機制,但解決的問題完全不同。Merkle 腳本樹是密碼學約束機制,目標在於最小化鏈上資料負擔與保護未執行路徑隱私;工作流腳本樹則是軟體架構模式,目標在於提升模組複用性、實現細粒度異常隔離以及提供宣告式的執行管理。
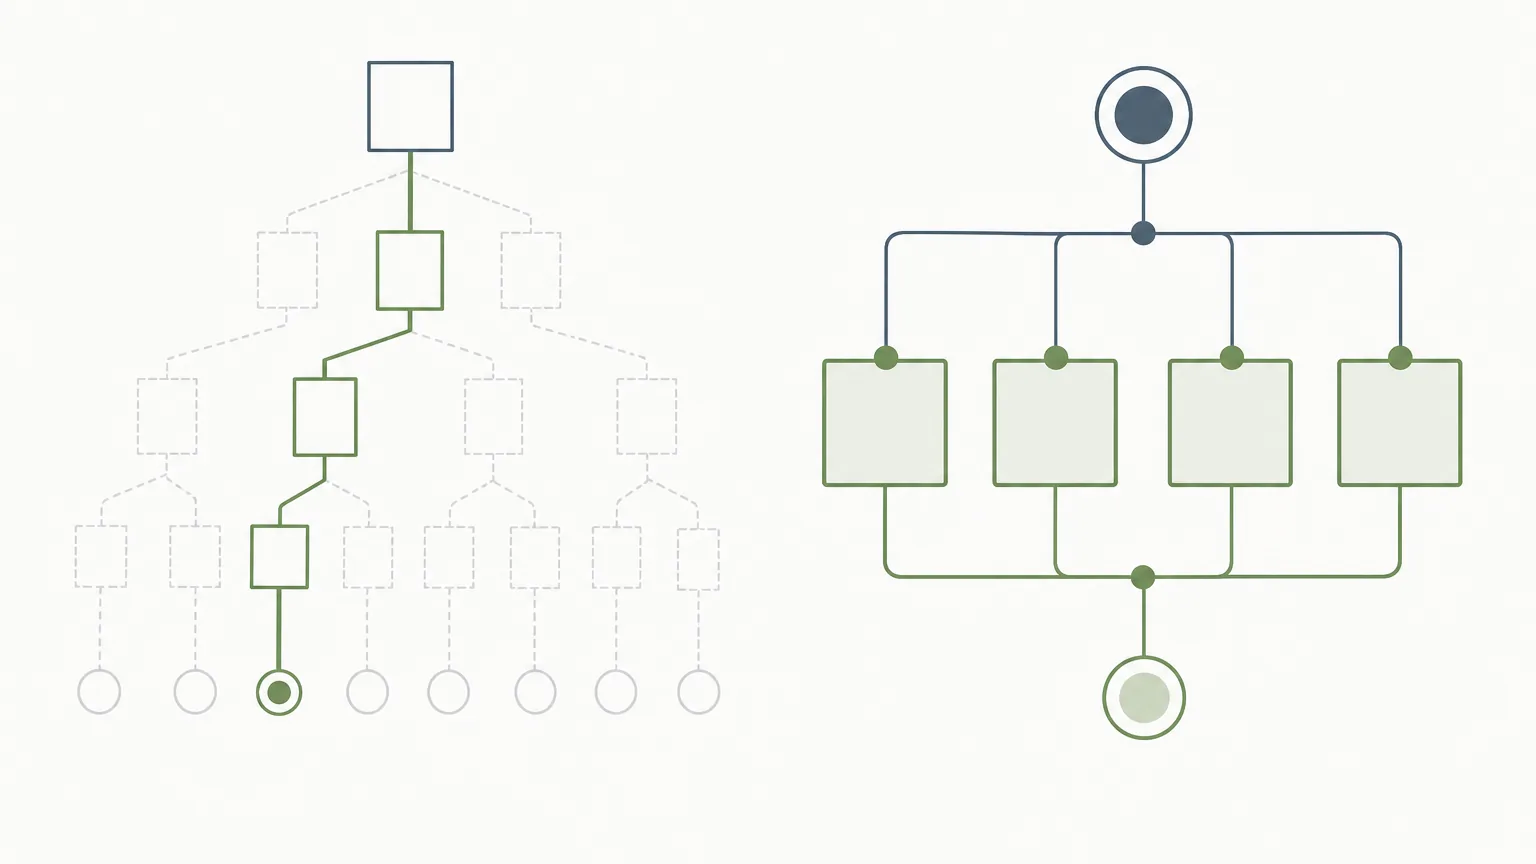
線性腳本向樹狀結構演進的觸發訊號
評估是否需要將既有自動化腳本升級為腳本樹架構,通常取決於以下幾項維護性瓶頸:
- 邏輯片段高度重複:多條業務流程皆需調用身分認證、驗證碼解析或權限檢查,當介面規則變更時需多處手動同步。
- 錯誤處理粒度粗糙:局部節點因網路抖動或超時中斷時,缺乏局部分支重試或狀態復原路徑,往往只能將整條主流程全部重跑。
- 全域變數汙染與競態:變數作用域未受約束,各子步驟隨意讀寫全域上下文,導致多任務執行時資料被覆寫。
- 無效的序列阻塞:原本互不依賴的資料查詢或檢查步驟被強制按線性順序排列,拉長整體端到端執行時間。
依據標準工作流模型(可參考 Camunda 工作流模式規範),諸如平行拆分(Parallel Split)、排他選擇(Exclusive Choice)與同步聚合(Synchronization)均需要結構化模型支援。自建或引進腳本樹架構,本質上是為工程團隊提供一致的控制流詞彙表。
結構組成
節點:最小語意描述單元
腳本樹將單一任務分解為具備輸入契約、執行行為與輸出契約的節點。節點內部不耦合特定流程上下文,僅依據宣告的位置與依賴關係由引擎調度。
| 節點類型 | 控制流與職責說明 | 典型輸出與副作用 |
|---|---|---|
| 根節點 (Root) | 建立執行上下文、注入全域設定、啟動樹遍歷 | 整棵樹的最終執行摘要與狀態標識 |
| 序列節點 (Sequence) | 按陣列宣告順序依次執行子節點,前項失敗則中斷後續 | 子節點輸出產生的結構化列表 |
| 條件節點 (Condition) | 依據表達式求值結果決定路由,僅走入命中之子分支 | 命中分支的執行成果 |
| 並行節點 (Parallel) | 同時展開多條獨立子樹,支援全數完成或首個成功模式 | 分支執行集合,帶有各自分支的標籤標識 |
| 任務節點 (Task/Leaf) | 執行實體操作:呼叫 API、驅動瀏覽器、寫入資料庫 | 原始回應數據、狀態碼或寫入計數 |
| 補償節點 (Compensation) | 在前序關聯操作失敗時觸發,執行反向清理或回滾動作 | 資源復原確認標記、回滾成功/失敗日誌 |
| 聚合節點 (Aggregator) | 合併並行或迴圈輸出的異質數據,進行轉換與校驗 | 標準化資料模型或報表結構 |
最小可執行宣告範例
以下以宣告式結構示範一個包含登入、並行查詢、條件判斷與失敗補償的標準腳本樹片段:
name: OrderProcessingWorkflow
type: Root
context:
  tenantId: "TW_001"
  retryLimit: 3
children:
  - id: step_auth
    name: "身分認證"
    type: Task
    action: "authService.login"
    timeout: 5000

  - id: parallel_fetch
    name: "並行獲取資料"
    type: Parallel
    strategy: "AllSuccess"
    children:
      - id: fetch_orders
        type: Task
        action: "api.getOrders"
      - id: fetch_inventory
        type: Task
        action: "api.getInventory"

  - id: process_orders
    name: "訂單扣減與狀態更新"
    type: Sequence
    children:
      - id: deduct_stock
        type: Task
        action: "inventory.deduct"
        onFailure:
          triggerCompensation: "rollback_stock"
      - id: rollback_stock
        type: Compensation
        action: "inventory.restore"
        activeOn: "deduct_stock.FAILED"
      - id: confirm_order
        type: Task
        action: "order.complete"
上下文邊界與節點生命週期
上下文物件(Context)在整棵樹中傳遞。為了避免狀態混亂,標準設計通常限制寫入權限僅屬於宣告輸出的節點,下游客戶端透過輸入對齊(Input Mapping)明確取值。節點的標準生命週期包含:
準備 (Resolve):解析輸入參數並進行格式驗證 → 前置 (Before Hook):記錄軌跡日誌或建立隔離沙盒 → 執行 (Execute):調用底層實作 → 後置 (After Hook):驗證輸出完整性 → 回寫 (Commit):將結果併入父級或局部上下文。
執行流程逐步拆解
1. 語意解析與靜態校驗
在實際派發任務前,引擎需完成有向無環結構(DAG 或樹結構)校驗。核心檢查項包括:
- 拓撲完整性:確認不存在循環引用,各節點父子從屬關係明確。
- 參數契約滿足:若節點 B 聲明依賴節點 A 的輸出欄位,靜態檢查需驗證節點 A 必定在節點 B 的先驗路徑上執行完畢。
- 補償對稱性:檢查所有被標記為具備副作用的關鍵節點,是否均註冊了對應的補償處理器。
2. 遍歷調度策略
樹狀結構可依據任務屬性選擇合適的控制流遍歷路徑:
| 策略名稱 | 調度特性 | 適用場景與潛在成本 |
|---|---|---|
| 深度優先 (DFS) | 單一業務分支沿著子節點一路執行到底 | 適用於強順序、長鏈路業務;並行吞吐能力有限 |
| 廣度優先 (BFS) | 按層級逐層解析條件,完成同層前置檢查再深入 | 適用於多源預檢查;狀態需長時間維持在記憶體中 |
| 非同步事件驅動 | 子節點遇等待(如人工審批、Webhook)時掛起持久化 | 適用於長週期任務;需外部存儲支援狀態重載 |
3. 重試收斂與 Saga 補償機制
在分散式系統與多端自動化中,網路抖動與下游服務不可用是常態。重試與補償有著明確的語意分工:
重試(Retry)建立在「錯誤為瞬時發生、再次執行有機率恢復」的假設上,必須配置退避算法(Exponential Backoff)與上限,避免盲目重試引發連鎖雪崩;補償(Compensation)則建立在「主流程不可恢復、必須消除既有副作用」的假設上,透過反向操作維持系統最終一致性。
依據 Temporal Saga 模式架構說明,跨系統協調無法依賴傳統關聯式資料庫的二階段提交,每個正向節點都必須在宣告時明確關聯補償邏輯。當並行或序列中途發生不可修復異常時,引擎將循相反路徑觸發已完成步驟的補償節點。
實際應用場景
1. 複雜網頁採集與會話維護
在長鏈路網路採集中,根節點負責建立虛擬環境與載入認證 Session。登入流程模組化為單獨子樹,包含驗證碼辨識與多因素驗證處理。多個目標頁面的爬取與資料剖析則掛載於並行節點下執行。各子分支遇到防爬驗證時,可局部觸發「重新登入」子樹,更新認證憑證後原位重試,無需讓所有採集線程全部重啟。
註:自動化採集需嚴格遵循目標站點的服務條款、Robots 協議及相關資料隱私保護法規。
2. 雲端部署與 CI/CD 運維編排
標準自動化部署本身即是高度結構化的樹狀控制流。靜態代碼檢查、容器鏡像構建與安全掃描可配置於並行分支中同時展開。驗證通過後,序列節點依次進行備份、滾動發布與自動化健康檢查。若健康探針回傳異常,引擎自動攔截後續流量切換,直接走入回滾補償子樹還原鏡像版本。
3. 企業級 RPA 與後台流程整合
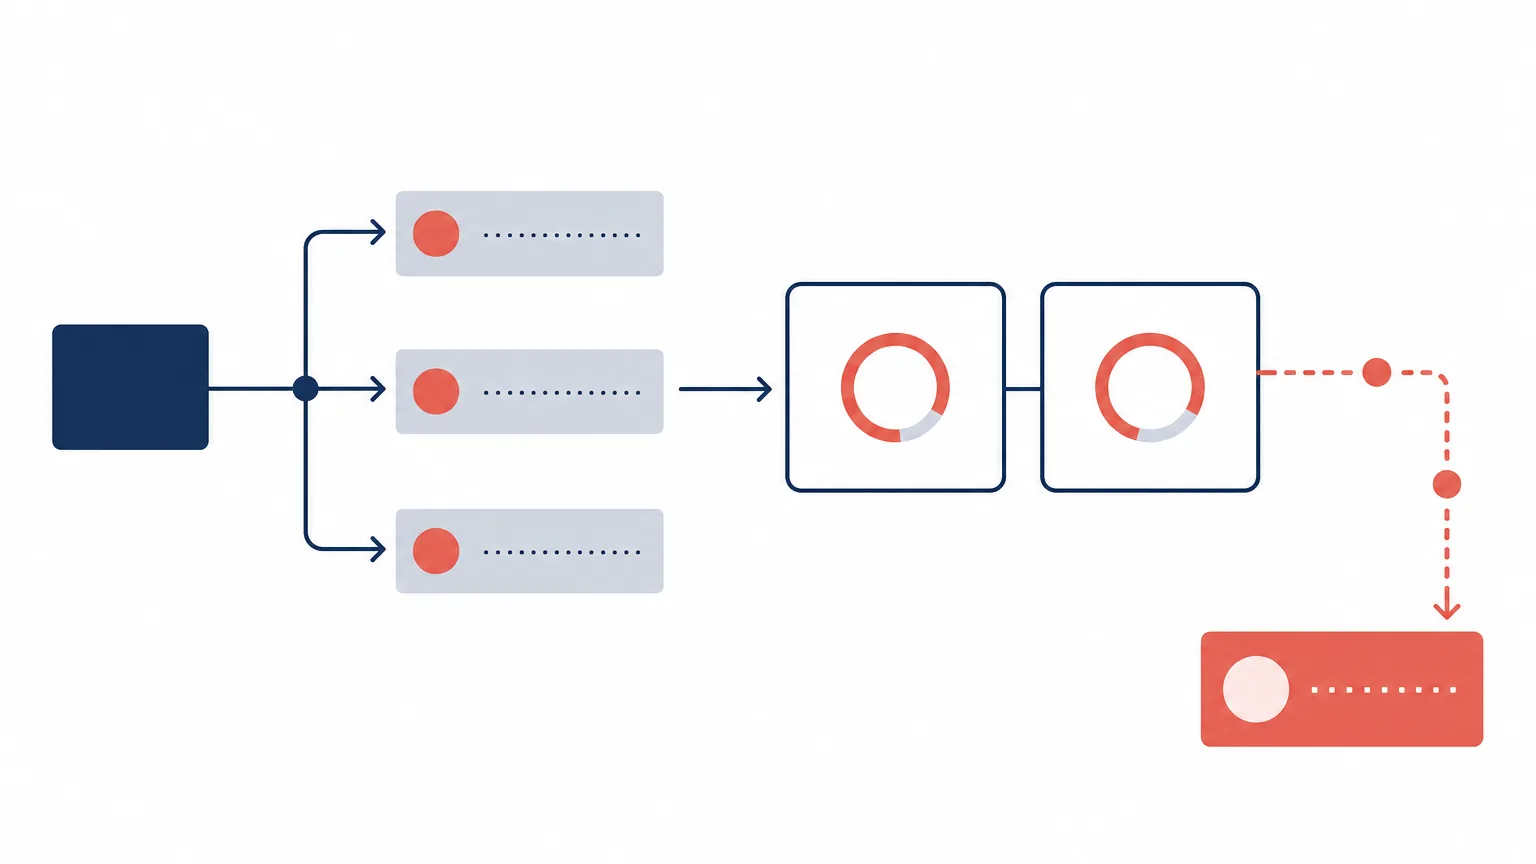
在處理跨舊版系統(Legacy System)資料同步時,腳本樹透過迴圈節點對待處理清單逐筆遍歷。每筆記錄獨立享有完整的異常捕捉機制。當單筆資料因欄位不合法或外部系統超時處理失敗時,補償節點記錄審計日誌並發送告警,主流程則維持繼續處理其他資料,最後由聚合節點產出「部分成功」執行報表。
架構設計實務守則與避坑指南
- 維持節點冪等性(Idempotency):所有具備資料寫入或外部呼叫性質的葉節點,均應設計為可安全重試。建議在請求層附帶依據 Execution ID 生成的唯一冪等鍵(Idempotency Key),防止重試造成重複扣款或重複寫入。
- 嚴格限制全域可變狀態:避免節點在執行期直接修改共享上下文。並行節點應各自產出局部輸出,統一交由聚合節點(Aggregator)進行結構化合併,徹底杜絕多執行緒競態。
- 設定合理的節點粒度:不要將單純的三行輔助函式切成多個微小節點,也不應將整套業務邏輯塞進單一任務節點。判斷基準為:該步驟是否具備獨立重試、跳過或補償的需求。
- 鏈路追蹤標識貫穿:在根節點初始化唯一的 Trace ID,並將其自動注入所有子節點日誌與對外 HTTP Header 中。當非同步或並行流程在生產環境發生問題時,能透過追蹤標識還原整棵樹的執行時序。
常見問題 (FAQ)
Q1:腳本樹架構與一般的線性腳本、函式調用有何本質區別?
線性腳本將「業務邏輯」與「流程控制(如重試、超時、例外捕獲)」強耦合在一起。腳本樹將控制流提煉為宣告式的結構配置,節點本身僅專注於純粹的業務邏輯,控制邏輯交由引擎統一管理,大幅提升可視化程度、複用性與排錯效率。
Q2:什麼時候不建議引入腳本樹?
當任務流程簡單(步驟在 5 步以內)、無複雜條件分流、無並行調度需求且失敗時允許直接全量中斷重跑時,傳統腳本更為簡練直接。引入腳本樹需要解析引擎與宣告成本,應在維護成本超過解析成本時再進行重構。
Q3:如何在腳本樹中安全處理外部系統的長調用?
應將同步等待改造為事件驅動或輪詢機制。配置節點超時(Timeout)邊界,並將任務狀態持久化至資料庫。等待外部回調時掛起該分支,釋放執行緒資源,待收到 Webhook 或輪詢信號後再自原節點恢復執行。



