
你在錢包裡按下確認,交易雜湊(Hash)出現在畫面上。把這串 0x 開頭的字串貼進區塊瀏覽器,幾秒後頁面就呈現出區塊高度、手續費、代幣轉移紀錄,甚至連合約內部呼叫的細節都列得整整齊齊。這個過程表面上像在查詢一個常規網頁,實際上背後運作著一條相當龐大的資料處理管線:從底層節點拉取區塊原始位元組、解碼事件日誌、寫入關聯式索引,最終由前端轉譯為清晰直觀的視覺化圖表與數據。
深入拆解這條管線,不僅能理解為什麼同一個地址在不同平台上的載入速度有所差異,也能明白為何同一筆交易在不同區塊瀏覽器上顯示的「內部轉帳」數量可能存在出入。以下沿著鏈上數據的流動方向,逐步剖析從節點到使用者介面的完整技術架構。
節點:鏈上數據的原始來源
區塊瀏覽器本身不生產數據,其所有基礎資料皆來自運行區塊鏈客戶端軟體的節點。以太坊執行層常見的客戶端包含 Geth、Nethermind、Besu、Reth 與 Erigon;比特幣網路則主要依賴 Bitcoin Core。節點透過 P2P 網路接收區塊與交易,驗證簽名、默克爾證明(Merkle Proof)及狀態轉換的合法性,驗證無誤後寫入底層資料庫。
全節點、歸檔節點與狀態資料
一般全節點(Full Node)僅保留近期的狀態樹(State Trie),歷史的中間狀態會進行狀態修剪(Pruning)以節省磁碟空間。而歸檔節點(Archive Node)則完整保留歷史上每一個區塊高度的狀態快照。若區塊瀏覽器需要即時查詢特定地址在數年前某個高度的歷史餘額或合約儲存槽,就必須直接存取歸檔節點或依賴索引器在該歷史時點預先擷取的資料快照。
JSON-RPC:索引器與節點的溝通協定
節點通常對外開放標準 JSON-RPC 介面。以太坊執行層客戶端的介面規範以公開的 Execution APIs 為基準。核心命名空間包含負責區塊、交易與日誌查詢的 eth_,以及負責執行追蹤的 debug_ 或 trace_。
| RPC 方法 | 取得內容 | 典型用途 |
|---|---|---|
eth_getBlockByNumber |
區塊頭、交易雜湊或完整交易列表 | 建立區塊高度與交易基本索引 |
eth_getTransactionReceipt |
執行狀態、實際 Gas 消耗量、事件日誌 | 解析代幣轉帳事件與交易成敗判定 |
eth_getLogs |
符合特定過濾條件的事件日誌陣列 | 批次同步合約事件與歷史資料補齊 |
eth_getCode / eth_getStorageAt |
合約位元組碼、指定儲存槽資料 | 識別代理合約架構、讀取合約常數 |
debug_traceTransaction |
完整呼叫堆疊(Call Trace)與狀態差異 | 推導原生代幣內部轉帳與合約執行流程 |
需要特別注意的是,debug_traceTransaction 並非所有節點的預設開放介面,執行該類追蹤通常需要極高的計算與 I/O 成本。這也是部分輕量級區塊瀏覽器僅展示頂層交易,而專業級瀏覽器能完整列出合約內部調用層級的關鍵差異所在。
資料擷取與區塊鏈重組處理
索引服務通常透過 WebSocket 訂閱新區塊頭推播(例如 newHeads),並輔以定時輪詢(Polling)作為網路斷線或重連時的兜底容錯機制,確保每一筆新區塊都能被即時擷取。
鏈重組(Reorganization)的容錯機制
在去中心化網路中,受網路傳播延遲、驗證者投票時序差異或客戶端暫態影響,鏈端偶爾會出現短暫分叉。當共識機制確認主鏈時,被捨棄的孤塊(Orphan Block)內的資料必須被回滾。
為防止資料庫出現髒資料,區塊瀏覽器的索引系統會設定「安全確認深度」。鏈頭最新的數個區塊會暫存在記憶體快取或暫存表格中,並在寫入資料庫時透過區塊父雜湊(Parent Hash)檢查連續性。一旦偵測到分叉,索引器會觸發回滾邏輯,刪除無效分叉上的交易與事件,重新同步主鏈數據。
資料解碼:位元組到結構化語意
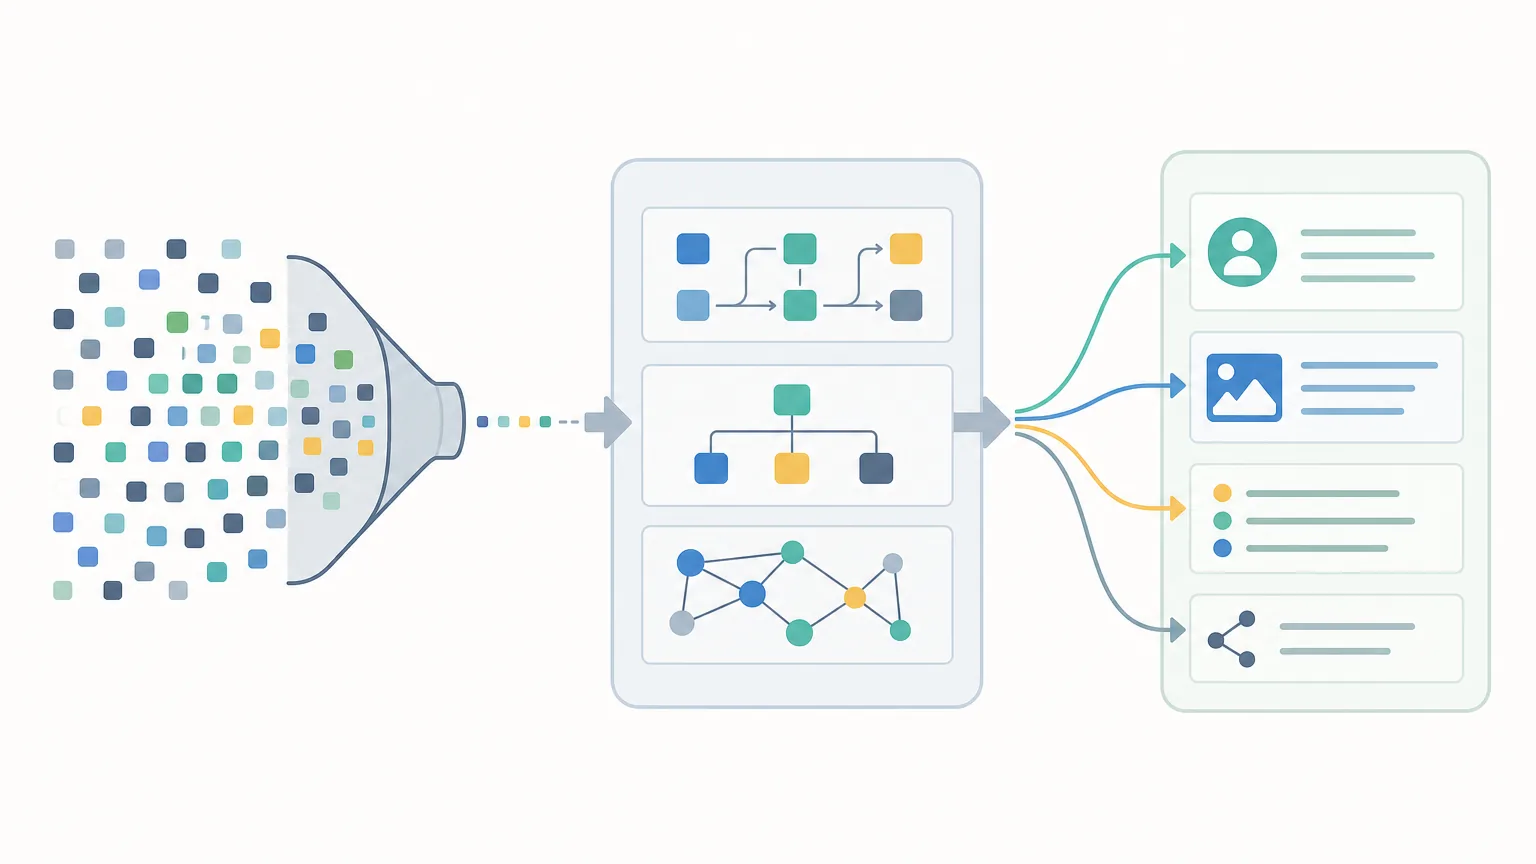
節點原始輸出的資料皆為十六進位位元組串。將其轉換為使用者可讀的合約名稱、函數參數與轉帳金額,依賴於應用二進位介面(ABI)的解碼技術。
事件日誌與標準代幣解析
以符合 ERC-20 標準的轉帳事件為例,其事件簽名為 Transfer(address,address,uint256)。該字串經 Keccak-256 運算後的雜湊值固定儲存於日誌的 topic[0],宣告為 indexed 的發送方與接收方地址分別置於 topic[1] 與 topic[2],未加 indexed 的金額數值則存放於資料區塊(data)。索引器透過標準 ABI 庫比對簽名雜湊,即可將位元組還原為清楚的轉帳數值。
代理合約(Proxy Contracts)與實作位址識別
許多智慧合約採用可升級的代理模式。使用者互動的合約僅作為轉發層,業務邏輯儲存於邏輯合約中。依照 EIP-1967 等標準,實作合約位址會寫入特定的儲存槽。索引器必須讀取該儲存槽位址並提取其實作合約的 ABI,否則將無法精準解碼合約內部的自訂方法與事件日誌。
內部轉帳(Internal Transactions)的來源差異
在合約執行期間由合約發起給外部地址或其他合約的原生代幣轉移,屬於內部執行狀態變更,鏈上預設不會自動生成收據日誌。要捕獲此類原生代幣內部流向,必須依賴節點的 Trace 模組(如呼叫框架分析或狀態差異比對)。若僅透過標準日誌解碼,便只能獲取標準代幣的轉移,這造就了各平台在內部交易深度呈現上的技術門檻。
索引與資料庫架構設計
直接透過節點 RPC 進行跨區塊或多維度搜尋效率極低。區塊瀏覽器的本質是一個高效能的資料倉儲系統,將鏈上原始數據清洗並結構化至關聯式資料庫(如 PostgreSQL)、分時序列庫或列式分析資料庫(如 ClickHouse)。
- 區塊表(Blocks):記錄高度、區塊雜湊、驗證者、Gas 上限與實際消耗量、時間戳記。
- 交易表(Transactions):以交易雜湊為主鍵,建立
from_address、to_address、區塊高度與交易序號的高效複合索引。 - 代幣轉移表(Token Transfers):儲存代幣合約、轉出方、接收方與解碼後的精度換算金額。
- 持倉快照表(Balances & Token Holdings):透過事件監聽維護增量帳本,同時依賴非同步排程與合約唯讀方法進行週期性對帳。
為滿足海量高頻的查詢需求,搜尋引擎(如 Elasticsearch)常用於處理位址前綴、合約名稱與方法簽名的全文檢索,而熱門位址與最新區塊資訊則透過分散式快取(如 Redis)進行高併發支撐。
前端視覺化呈現與驗證機制
當資料透過 API 傳送至前端時,區塊瀏覽器需進行精度換算、地址校驗與安全標記等細節處理。
EIP-1559 交易手續費計算
在以太坊 EIP-1559 機制下,一筆交易所支付的實際手續費由以下公式決定:
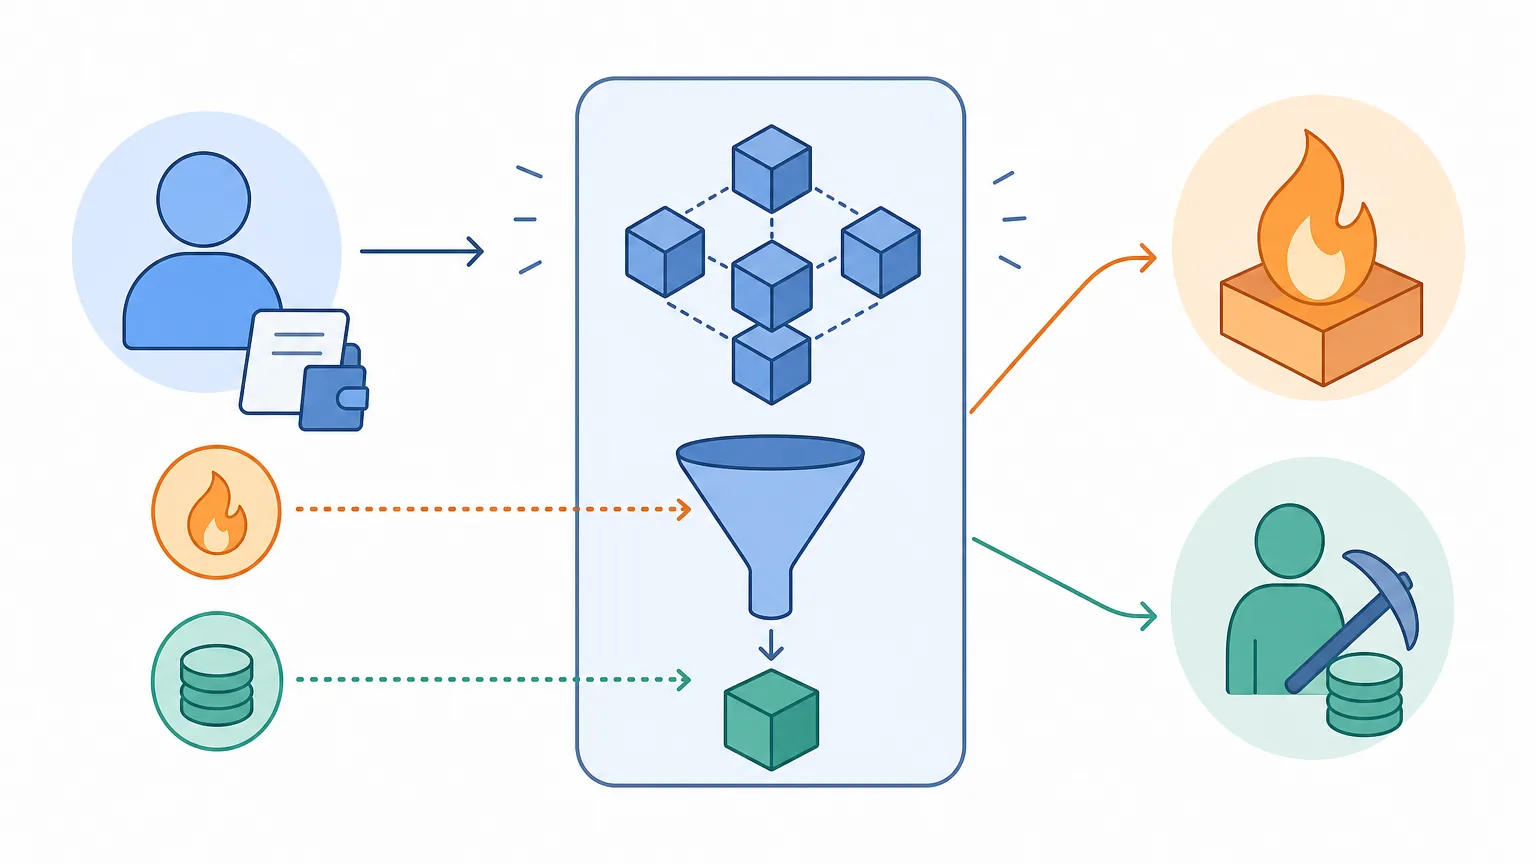
實際手續費 = Gas 消耗量 (gasUsed) × 實際 Gas 費率 (effectiveGasPrice)
其中 effectiveGasPrice = min(maxFeePerGas, baseFee + maxPriorityFeePerGas)
前端介面會將基本費(baseFee,該部分會被銷毀)與優先費(priorityFee,獎勵給驗證者)進行視覺化拆解,協助使用者評估網路擁塞程度與出價合理性。
地址校驗與合約原始碼比對
前端依據 EIP-55 標準,利用雜湊大小寫規則自動轉換地址格式,防止使用者因手民之誤轉錯資產。針對智慧合約,區塊瀏覽器提供驗證編譯服務:開發者上傳原始程式碼與編譯參數,系統重新編譯後將產出的位元組碼與鏈上字節碼比對,完全吻合時賦予綠色勾選標記,並開放合約線上讀寫介面。
常見問題(FAQ)
Q1:為什麼有時候交易已經在錢包顯示成功,在區塊瀏覽器上卻查不到?
通常有兩個原因:第一是索引延遲,節點接收到區塊後,後端索引器需要極短的時間進行解碼與資料庫寫入;第二是錢包連接的 RPC 節點與瀏覽器背後的節點群存在同步時間差,特別是在網路短暫延遲或分叉時更為明顯。
Q2:為什麼不同區塊瀏覽器顯示的合約「內部交易」數量有時不一樣?
內部交易不是直接記錄在區塊收據中的日誌,而是合約在虛擬機內部執行呼叫時產生的原生狀態轉移。獲取內部交易需要運行完整的節點追蹤(Trace)模組,各家瀏覽器所採用的 Tracer 演算法、過濾深度(例如是否忽略零金額調用)或支援的客戶端介面存在差異,導致解析結果有些許不同。
Q3:區塊瀏覽器上標註的「已驗證合約」能保證資金絕對安全嗎?
不能。「已驗證」僅代表開發者公開的 Solidity/Vyper 原始碼經編譯後,產生的位元組碼與鏈上部署的完全一致,代表邏輯透明度,並不等同於合約通過了安全審計或不存在後門與邏輯漏洞。



