
凌晨一點四十分,搜尋欄裡躺著「技術百科閱讀順序」這串字,原本只打算弄清楚一個快取機制到底在哪個環節生效。四十分鐘後,瀏覽器掛著二十多個分頁,從快取標籤跳到一致性模型,再跳到某個分散式系統的共識演算法,最後停在一篇關於早期作業系統排程的長篇考據。回頭看最初那個疑問,依舊懸而未決,螢幕上密密麻麻的超連結仍在閃爍。
這種經驗在軟體開發與技術研究中屢見不鮮。問題的核心不在於專注度不足,也不在於條目撰寫品質欠佳,而是技術百科這類文本的組織邏輯本質上是非線性、層次化且高度交叉引用的。當讀者習慣用線性閱讀長篇散文或教學手冊的方式逐字掃描,注意力極易在資訊節點之間渙散。
掌握清晰的技術百科閱讀順序,本質上是建立一套主動過濾與分層驗證的機制。梳理常見的檢索誤區,並轉換為結構化的四層閱讀法與驗收策略,能讓非線性文本轉化為扎實的工程決策依據。
誤區一:跳過資訊框與首段,直接撲向程式碼範例
許多工程師查閱技術條目時,習慣直接搜尋範例程式碼區塊。然而,範例程式碼往往預設了執行環境與前置條件,很少主動說明「此 API 依賴非同步模式開啟」或「該呼叫方式在特定版本後已不建議使用」。
這些關鍵邊界通常收斂在兩個區域:頁面頂部或右側的資訊框(Infobox),以及條目的第一段摘要。
資訊框是快速的相容性檢查表,集中呈現穩定版本、釋出日期、維護狀態、授權條款與支援平台等欄位。Wikipedia:Manual of Style/Lead section 說明,首段是條目的引言與核心摘要。一段合格的首段會迅速界定該技術的本質歸屬、核心特性及其與相近概念的界限。讀完首段即可判定該條目是否吻合當前需求;若不吻合,果斷關閉分頁就是最省時的選擇。
- 檢視標題下方的消歧義或分類註記,確認未找錯概念。
- 掃描資訊框關鍵欄位:維護狀態、目前穩定版本與授權範圍。
- 完整閱讀首段,提煉出該技術的「一句話核心定義」。
- 瀏覽首個二級標題(如「概述」或「架構」),掌握最濃縮的運作邏輯。
誤區二:把目錄當成裝飾,靠手指漫無目的地滾動
長篇技術條目的目錄是整套知識體系的骨架。Wikipedia:Manual of Style/Layout 指出,標準條目章節順序遵循特定架構邏輯:先定義、再機制、後實作、最後才是邊界、歷史與參考資料。跳過目錄直接滑動瀏覽,等於放棄了現成的導航路標。
無序滾動容易帶來進度焦慮,缺乏結構感會讓認知負荷持續攀升。開始深讀之前,花一分鐘快速掃描目錄並分配閱讀權重,能大幅提升吸收效率:
- P0(關鍵層):架構、資料模型、核心機制——不讀懂則無法解答當前問題。
- P1(補充層):設定範例、延伸特性——有助於理解得更完整,可後續查閱。
- P2(邊緣層):歷史沿革、命名由來、文化影響——除非涉及向下相容考證,否則首輪一律略過。
誤區三:每個陌生術語都開新分頁,造成認知超載
閱讀分散式系統條目時遇到新名詞,若習慣立刻另開分頁,往往會引發連鎖反應:從一致性雜湊跳到虛擬節點,再跳到叢集拓撲,最終迷失在分頁堆疊中,切斷了原始問題的脈絡。
心理學研究指出,頻繁的任務切換會產生成本並分散注意力資源。在技術閱讀中,每一次分頁切換都意味著上下文的卸載與重新加載,過度跳躍會直接削弱對主線概念的深度理解。
應對策略在於設定嚴格的分頁連結預算:閱讀單一章節時,即時另開分頁上限設為兩個。其餘偶遇的生疏名詞,可先記錄在暫存清單中:
誤區四:忽略版本範圍、棄用聲明與維護標記
技術條目具備動態時效性。某些基礎協定的定義可能數年不變,但其實踐套件的 API 語法或部署指令可能每半年就有所更迭。忽略版本標籤,極易採納已經過時的實作方式。
誤區五:只看優點特性,略過邊界限制與替代方案
技術條目前半部常詳細列舉設計架構與效能優勢,而「已知限制」、「效能瓶頸」或「替代方案比較」往往置於後段。然而,技術決策的關鍵往往在於「何時不該使用它」。
閱讀邊界章節時,應將抽象條款轉化為專案的具體約束:條目提及「高併發寫入時鎖競爭加劇」,需評估自身系統的峰值寫入量;條目列出「不具備跨節點強一致性」,則需確認業務是否容許最終一致性。提早審視比較章節,能及早發現更契合需求的候選方案。
誤區六:將百科條目當成逐步上手教學
技術百科的定位在於「概念定義、運作機制與生態定位」,屬於描述性文本;入門教學則屬於「操作指令、環境搭建與除錯指南」的程序性文本。帶著執行指令的目的硬讀百科,容易感到枯燥繁瑣;反之,若想理解系統架構卻只看程式碼片段,則難以看清全貌。
- 理解機制與架構:查閱技術百科,依據層次化架構梳理核心流程。
- 本地環境部署與 API 呼叫:直接參閱官方 Quickstart 或 API 規格文件。
- 特定錯誤代碼排查:利用錯誤日誌精準搜尋 Issue 追蹤清單或技術問答社群。
誤區七:在歷史演革與參見連結中迷航
條目開頭的歷史沿革往往篇幅龐大,過早深究容易過早耗盡精力。歷史章節的最佳閱讀時機在於「反向求證」:當讀到某個特殊相容設定或看似冗餘的欄位時,再回頭檢視歷史脈絡,往往能瞬間理解其演進背後的妥協原因。
同樣地,文末的「參見」與「外部連結」屬於條目的延伸出口。在尚未完成當前主題的核心筆記之前,不宜過早點擊外部鏈結,以免閱讀節奏被打亂。
修正核心:四層閱讀模型與驗收機制
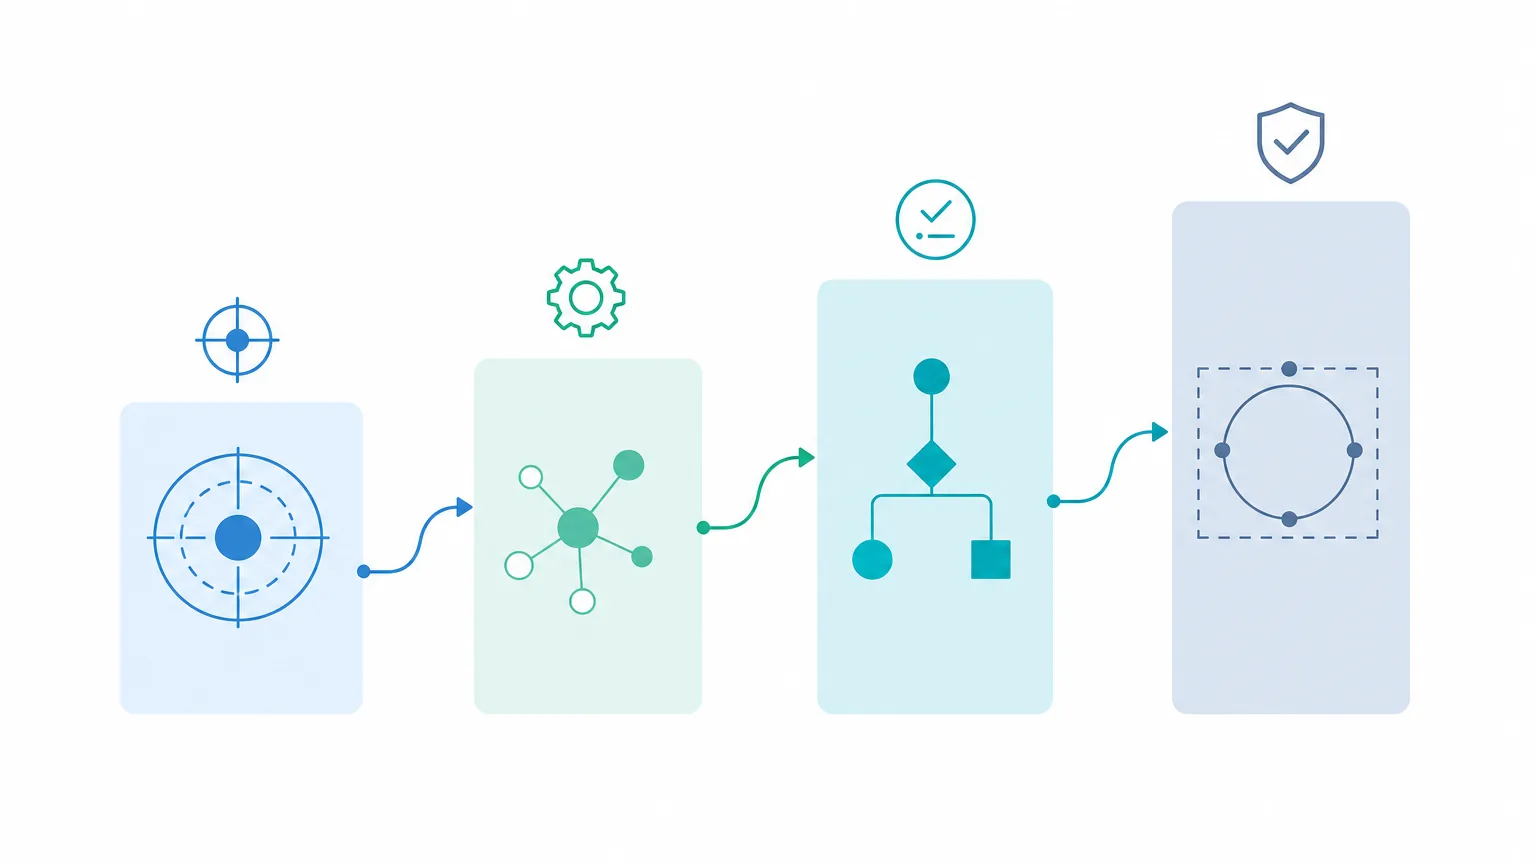
要建立高效的技術百科閱讀順序,核心在於將條目拆解為四個漸進層次,每層均設置具體的驗收問題。當前層次通過後,再向下推進。
L1 定位層:界定範圍與關聯度
閱讀目標:標題、消歧義、資訊框基礎欄位、首段與目錄。
驗收問題:「能否用一句話說明它是什麼,以及它是否與要解決的技術問題直接相關?」
L2 機制層:理解內部運作邏輯
閱讀目標:「架構」、「核心概念」、「運作原理」章節。
驗收問題:「能否在白板上簡要畫出該技術的核心資料流向或元件互動圖?」
L3 操作層:掌握正確調用前提
閱讀目標:核心配置、主要 API 規格及基本使用範例。
驗收問題:「能否說明範例程式碼各主要參數的作用,以及其適用的版本與環境前提?」
L4 邊界層:識別限制與風險
閱讀目標:已知問題、效能限制、安全性考量與競品比較表。
驗收問題:「列舉出兩個不建議使用該技術的情境,以及對應的替代方案是什麼?」
以「3+1 問題法」鎖定閱讀目標
防止資訊膨脹的有效方式,是在打開條目之前先確立目標。在筆記中寫下三個正面驗證問題與一個反面邊界問題:
- 它主要解決系統中的哪個環節問題?
- 它的核心運作流程或演算法依據是什麼?
- 引入系統時需要改動現有架構的哪些部分?
- (反面問題)在何種負載、架構或規模下,使用它會帶來副作用?
目標問題確立後,閱讀便從被動接收轉為主動檢索。一旦四個問題獲得明確解答,便可即刻停止擴充查閱,進入實作驗證階段。
不同條目類型的閱讀路徑微調
技術條目主題各異,切入順序應隨之靈活調整,以求在最短時間內抓住重點:
結構化筆記與輕量複查
養成高效閱讀習慣需要輕量的輸出閉環。單次閱讀結束後,花數分鐘記錄三行核心筆記:
- 一句話本質定義:用個人語言提煉技術定位,加深認知結構。
- 一項核心限制邊界:明確記錄其失效情境或不適用環境。
- 一個後續待驗證問題:留待程式碼實作或架構測試中實際驗證。
隔日快速瀏覽三行筆記,確認對核心概念的理解是否存在偏差。搭配極小規模的 POC(概念驗證)或程式碼除錯,能將抽象條目快速轉化為工程能力。



